Introspekcja poddrzewa – UNPIVOT DRZEWA
Opis
Operacja mapowania Introspekcja poddrzewa – UNPIVOT DRZEWA (UnpivotTreeOperation) opisuje całe poddrzewo danych w postaci płaskiej listy wierszy: po jednym wierszu na każdy rekord poddrzewa, łącznie z samym rekordem, na którym operacja stoi. Każdy wiersz mówi, gdzie rekord leży, skąd pochodzi (adnotacje, np. powiązanie z modelem danych EDMX) i co zawiera (pola z wartościami).
To rozbudowana wersja operacji Zamiana pól rekordu na wiele rekordów klucz-wartość – UNPIVOT (UnpivotRecordOperation), która zamienia pola tylko jednego rekordu na pary klucz-wartość.
- Wejście – dowolny rekord w schemacie (pojedynczy albo wielokrotny) wraz z całym poddrzewem.
- Wyjście – nowy, wielokrotny rekord podrzędny UnpivotTree, dodawany do rekordu startowego.
Kiedy używać
Operacja przydaje się wtedy, gdy trzeba wykonać to samo działanie na wielu strukturach, tabelach lub przypadkach biznesowych. Zamiast budować osobne mapowanie dla każdego przypadku, można działać na opisie całej struktury jak na zwykłych danych, czyli przejść o jeden poziom abstrakcji wyżej.
Przykładowo: po serii operacji, np. Zapytanie do modelu danych na kilku powiązanych strukturach, jedna operacja zamienia wynik w listę opisów – identyfikatory struktur, nazwy tabel i kolumn, źródła wartości, wartości pól. Kolejne operacje (wybór, usuwanie, mapowanie) robią z tego np. wsad do logu albo dane w postaci klucz-wartość.
Typowe zastosowania:
- archiwizacja lub anonimizacja danych w wielu tabelach naraz,
- generowanie skryptów SQL na podstawie struktury danych,
- analiza, które pola są mapowane i skąd pochodzą ich wartości.
Dane wejściowe
Dowolny rekord w schemacie (pojedynczy albo wielokrotny) wraz z całym poddrzewem – np. rekord wczytany operacją Zapytanie do modelu danych albo dowolny inny rekord struktury.
Jak dodać operację
- W schemacie zaznacz rekord, od którego ma się zaczynać opis (np. rekord wczytany operacją Zapytanie do modelu danych).
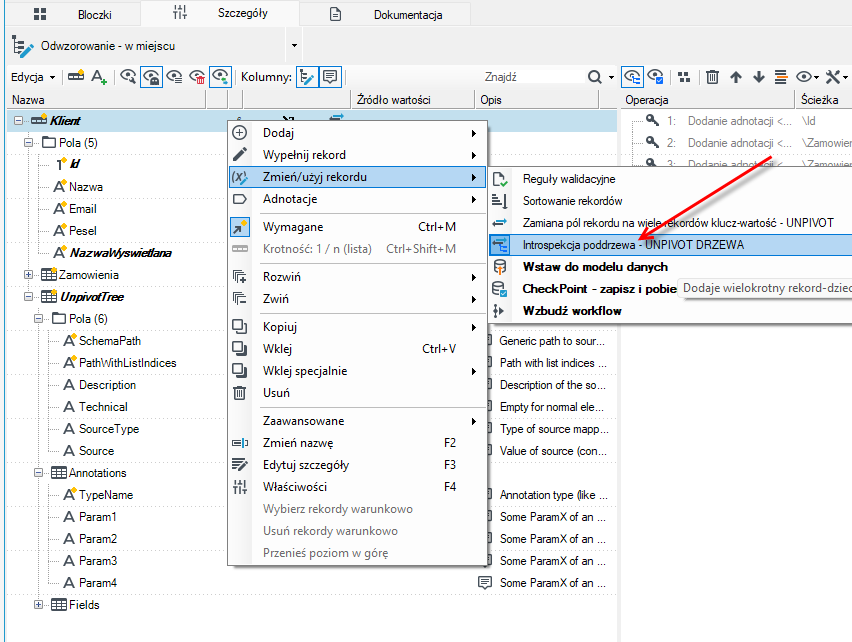
- Z menu kontekstowego rekordu wybierz Zmień/użyj rekordu → Introspekcja poddrzewa – UNPIVOT DRZEWA (obok operacji Unpivot).
- Operacja powstaje automatycznie – na liście operacji ma ikonę strzałek z drzewkiem.
- Opcjonalnie ustaw właściwość Uwzględniaj rekordy i pola techniczne (patrz Właściwości operacji).
Operacja opisuje stan danych w miejscu, w którym stoi na liście operacji – rekordy i pola dodane przez późniejsze operacje nie trafiają do opisu.
Wynik operacji możesz przetwarzać dalej kolejnymi operacjami mapowania, np. kopią, zawężeniem do potrzebnych elementów albo usunięciem zbędnych danych.
Przykład — rekord z modelu danych i lista dwóch rekordów przez relację
Struktura danych Klient (tabela dbo.KLIENT) ma relację listową Adresy do struktury Adres (tabela dbo.ADRES). Mapowanie zawiera kolejno:
| # | Operacja | Ścieżka | Uwagi |
|---|---|---|---|
| 1 | Dodanie rekordu | \Klient | |
| 2 | Dodanie pola | \Klient\Id | |
| 3 | Wyznaczenie wartości pola — Kopia wartości ..\Id | \Klient\Id | klucz zapytania |
| 4 | Dodanie rekordu | \Klient\Adresy | znacznik relacji do wczytania |
| 5 | Zapytanie do modelu danych — struktura Klient | \Klient | |
| 6 | Introspekcja poddrzewa | \Klient |
Po zapytaniu (operacja 5) klient ma dwa adresy. Operacja 6 dokłada UnpivotTree z trzema wierszami — jeden na klienta i po jednym na każdy adres:
Klient                                         (wczytany z modelu danych)
  Id     = 7
  Nazwa  = "ACME"
  Adresy                                       (lista, relacja)
    [0]  Id = 71, KlientId = 7, Miasto = "Kraków"
    [1]  Id = 72, KlientId = 7, Miasto = "Gdańsk"
  UnpivotTree                               (dodany przez operację — 3 wiersze)
    [0]  SchemaPath = ""        PathWithListIndices = ""
    [1]  SchemaPath = "Adresy"  PathWithListIndices = "Adresy[0]"
    [2]  SchemaPath = "Adresy"  PathWithListIndices = "Adresy[1]"
Szczegóły wierszy (identyfikatory struktur są przykładowe; lista pól skrócona — w rzeczywistości pojawiają się wszystkie pola struktury, także puste i audytowe):
Wiersz [0] — rekord startowy Klient
| Kolumna | Wartość |
|---|---|
SchemaPath / PathWithListIndices | (puste — to sam rekord startowy) |
Description | opis struktury z modelu danych, np. Klienci firmy |
Annotations | AEdmxRecUsage — Param1 = 5b1c0d3e-0a4f-4c2b-9e61-2d7f8a9b0c11 (ID struktury), Param2 = Klient, Param3 = dbo.KLIENT, Param4 = (puste — korzeń zapytania) |
Fields | Id = 7, SourceType = ACopy, Source = ..\Id; adnotacje: AEdmxField (Id, nazwa biznesowa, KL_ID, dbo.KLIENT), AMappingReadOnly |
Nazwa = ACME; adnotacja AEdmxField (Nazwa, nazwa biznesowa, KL_NAZWA, dbo.KLIENT) |
Wiersze [1] i [2] — elementy listy Adresy
| Kolumna | Wiersz [1] | Wiersz [2] |
|---|---|---|
SchemaPath | Adresy | Adresy |
PathWithListIndices | Adresy[0] | Adresy[1] |
Annotations | AEdmxRecUsage — Param1 = ID struktury Adres, Param2 = Adres, Param3 = dbo.ADRES, Param4 = Adresy (nazwa relacji) | jak obok |
Fields → Miasto | Kraków; AEdmxField (Miasto, …, AD_MIASTO, dbo.ADRES) | Gdańsk |
Fields → KlientId | 7; AEdmxField (…, AD_KLIENT_ID, dbo.ADRES) | 7 |
Gdyby klient miał trzy adresy, wierszy byłoby cztery; gdyby żadnego — jeden.
Struktura wyniku
Operacja dodaje do rekordu startowego nowy, wielokrotny rekord podrzędny UnpivotTree – po jednym wierszu na każdy rekord poddrzewa. Rekord startowy jest zawsze pierwszym wierszem, dalej rekordy idą w kolejności schematu, w głąb (rodzic, potem jego dzieci).
Wszystkie pola wynikowe są tekstowe. Jeżeli nazwa UnpivotTree jest już zajęta w rekordzie startowym, rekord wynikowy dostaje unikalną nazwę z sufiksem.
UnpivotTree – pola rekordu poddrzewa
| Pole | Zawartość |
|---|---|
SchemaPath | ścieżka od rekordu startowego, bez indeksów list, np. Adresy; dla samego rekordu startowego pusta |
PathWithListIndices | ta sama ścieżka z indeksami rekordów wielokrotnych, np. Adresy[1] albo Zamowienia[0]\Pozycje[2] |
Description | opis rekordu (adnotacja Opis) |
Technical | rodzaj danych technicznych (adnotacja Dane techniczne), jeśli rekord jest techniczny |
SourceType | krótka nazwa adnotacji wyznaczającej wartość (ACopy, AConst, AExpression), jeśli jest na rekordzie |
Source | tekst tej adnotacji: ścieżka źródłowa (kopia), wartość (stała) albo treść wyrażenia |
Fields – pola rekordu
| Pole | Zawartość |
|---|---|
Name | nazwa pola |
Value | wartość jako tekst – wg polityki konwersji bloczka, tak jak w operacji Unpivot |
Description | opis pola (adnotacja Opis) |
SourceType, Source | skąd pole dostało wartość w tym mapowaniu – jak dla rekordu (np. ACopy / ..\Id) |
Technical | rodzaj danych technicznych pola, jeśli jest techniczne |
Annotations – adnotacje rekordu lub pola
| Pole | Zawartość |
|---|---|
TypeName | krótka nazwa typu adnotacji, np. AEdmxRecUsage, AEdmxField, AKey |
FullTypeName | pełna nazwa typu (z przestrzenią nazw) |
ToString | tekstowa postać adnotacji |
Param1…Param4 | „popularne" parametry adnotacji – tylko dla adnotacji z listy niżej; dla pozostałych puste |
Pomijane są adnotacje, które mają własne pola wyżej (Opis, Dane techniczne, źródło wartości) oraz wewnętrzne adnotacje edytora mapowań. Pełną listę adnotacji opisuje rozdział Adnotacje.
Parametry Param1–Param4 według typu adnotacji
Wszystkie wartości są tekstowe. „–" oznacza parametr zawsze pusty. Do wybierania wierszy najwygodniej używać TypeName – to nazwy podane przy tytułach niżej. Obok tytułu jest też informacja, czy adnotacja występuje na rekordzie czy na polu.
Model danych (EDMX)
Rekord modelu encji – AEdmxRecUsage (w danych), AEdmxRec · rekord
Rekord powiązany ze strukturą danych: korzeń zapytania do modelu danych, relacja (pojedyncza lub lista) albo podstruktura.
| Parametr | Zawartość |
|---|---|
Param1 | ID struktury danych (GUID wersji); puste dla podstruktury |
Param2 | nazwa struktury; puste dla podstruktury |
Param3 | tabela w bazie, schemat.tabela; puste dla podstruktury (należy do tabeli rodzica) |
Param4 | nazwa relacji lub podstruktury, przez którą rekord jest osiągnięty; puste dla korzenia zapytania |
Pole modelu encji – AEdmxField, AEdmxFieldUsage (pole warunku zapytania) · pole
| Parametr | Zawartość |
|---|---|
Param1 | nazwa pola w modelu danych |
Param2 | nazwa biznesowa pola; puste, gdy nie zdefiniowano |
Param3 | kolumna w bazie danych |
Param4 | tabela właściciela pola, schemat.tabela |
Zapis do modelu danych – AEdmxInsert · rekord
Rekord zapisywany operacją zapisu do modelu danych. Tę samą postać ma AEdmxQuery, ale widać ją tylko w podglądzie edytora mapowań, nie w danych w trakcie przetwarzania.
| Parametr | Zawartość |
|---|---|
Param1 | ID struktury danych; puste, gdy nie wybrano struktury |
Param2 | nazwa struktury (podpowiedź zapamiętana przy wyborze) |
Param3 | nazwa bazy danych, jeśli wskazana |
Param4 | – |
Atrybut słownikowy – ADicAttributeRec · rekord
Rekord złożonego atrybutu elementu słownika, wczytany razem ze słownikiem.
| Parametr | Zawartość |
|---|---|
Param1 | nazwa typu atrybutu |
Param2 | wartość wyświetlana typu atrybutu |
Param3 | typ fizyczny wartości atrybutu (GUID) |
Param4 | położenie typu atrybutu w strukturze słownikowej |
Baza danych
Nazwa tabeli/kolumny – ADbObjectName · rekord albo pole
Nazwa tabeli (dla rekordu) lub kolumny (dla pola) w bazie, gdy różni się od nazwy w schemacie.
| Parametr | Zawartość |
|---|---|
Param1 | nazwa w bazie danych (może zawierać parametry w {…}) |
Param2 | nazwa używana tylko w czasie projektowania; puste, gdy nie podano |
Param3, Param4 | – |
Operacja bazodanowa – ADbAction · rekord
Co zapis do bazy ma zrobić z rekordem.
| Parametr | Zawartość |
|---|---|
Param1 | rodzaj operacji: None, Skip, Update, Insert, Delete, AUTO_InsertUpdate, AUTO_InsertOnly, Replace, TakeFromParent, Dynamic |
Param2 | nazwa źródła danych; puste = źródło danych bloczka zapisu do bazy |
Param3 | wyrażenie wyznaczające operację (dla Dynamic) |
Param4 | nazwa pola, do którego trafia oznaczenie wykonanej operacji |
Klucz główny, Klucz obcy, Autogeneracja – APrimaryKey, AForeignKey, AAutoGenerate · pole
Same znaczniki: pole jest kluczem głównym, kluczem obcym albo jego wartość wyznacza baza. Wszystkie parametry są puste – liczy się sama obecność wiersza z danym TypeName.
Słowniki i klucze
Słownik – ADictionary · pole
Odwzorowanie wartości pola przez słownik.
| Parametr | Zawartość |
|---|---|
Param1 | nazwa słownika |
Param2 | kolumna klucza |
Param3 | kolumna wartości |
Param4 | reakcja na brak klucza w słowniku: TRY_RECOVER, ERROR, EMPTY_DATA, SKIP |
Klucze własne – AKey · rekord
| Parametr | Zawartość |
|---|---|
Param1 | nazwy pól klucza rozdzielone ;, np. Kod;Oddzial |
Param2…Param4 | – |
Ograniczenia wartości
Wartość domyślna – ADefaultValue · pole
| Parametr | Zawartość |
|---|---|
Param1 | wartość domyślna w postaci tekstowej |
Param2…Param4 | – |
Zakres – ARange · pole
| Parametr | Zawartość |
|---|---|
Param1 | dolna granica; puste = bez ograniczenia |
Param2 | górna granica; puste = bez ograniczenia |
Param3 | czy dolna granica jest wyłączona z zakresu: True / False |
Param4 | czy górna granica jest wyłączona z zakresu: True / False |
Właściwości operacji
| Właściwość | Domyślnie | Znaczenie |
|---|---|---|
Uwzględniaj rekordy i pola techniczne (ProcessTechnicalRecords) | nie | gdy wyłączone, rekordy techniczne (razem z całym poddrzewem, np. rekordy błędów) i pola techniczne są pomijane. Gdy włączone – trafiają do opisu, a ich rodzaj widać w kolumnie Technical. |
Warto wiedzieć
- Źródła wartości pól zostają w schemacie. Obecność operacji w mapowaniu sprawia, że wszystkie operacje wyznaczania wartości pola w tym mapowaniu zostawiają swoje adnotacje (kopia, stała, wyrażenie, parser, słownik) na polach schematu – inaczej kolumny
SourceType/Sourcebyłyby puste. Przy bardzo dużych schematach oznacza to trochę więcej pamięci. - Doczytywanie relacji. Operacja przechodzi po wszystkich rekordach poddrzewa, więc relacje modelu danych, które nie zostały jeszcze wczytane (tryb leniwy), zostaną w tym momencie wczytane z bazy. Przy dużych drzewach ustaw introspekcję na możliwie wąskim rekordzie.
- Tylko rekordy obecne w danych. Rekord zdefiniowany w schemacie, ale nieobecny w instancji (np. pusta lista), nie daje wiersza.
- Wynik innej introspekcji jest zwykłym poddrzewem. Jeśli wcześniej w tym samym poddrzewie działała już taka operacja, jej
UnpivotTreezostaną opisane jak każdy inny rekord. Własny wynik operacji nie jest opisywany.
Co dalej z wynikiem
Typowe dalsze kroki w tym samym mapowaniu:
- usunięcie niepotrzebnych wierszy warunkiem na
SchemaPath,TypeNamealboValue(np. zostawienie tylko pól zAEdmxFieldi niepustą wartością), - przeniesienie
UnpivotTreedo rekordu przeznaczonego na log lub wysyłkę, - mapowanie par
Name/Value(alboParam3= kolumna /Value) na docelową strukturę klucz-wartość.
Przykład użycia
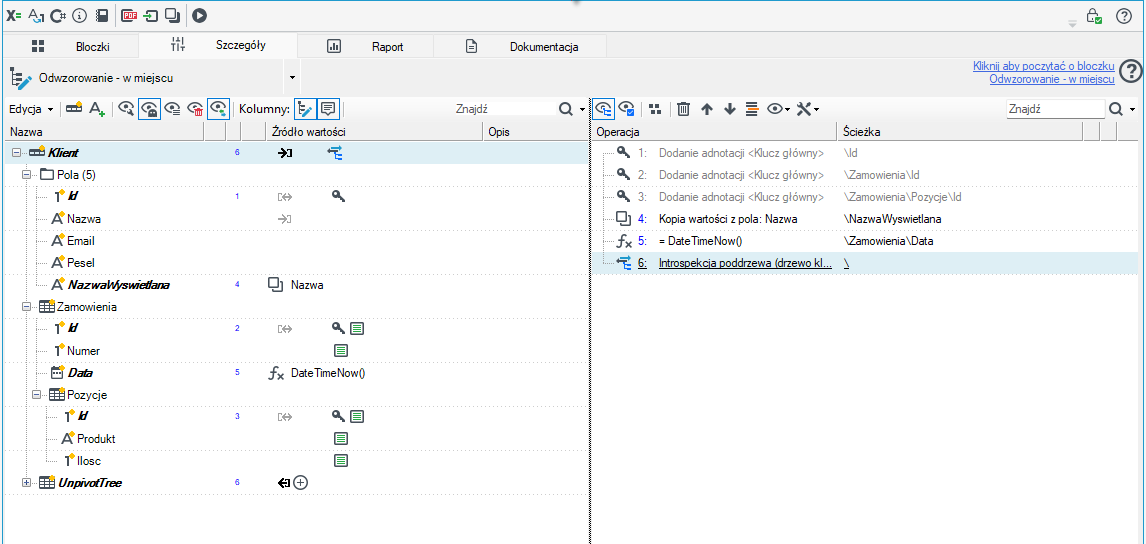
Poniżej znajduje się prosty przykład do odtworzenia w archITekt Studio: klient, jego zamówienia i pozycje zamówień, czyli trzy poziomy drzewa.
Tabele w bazie danych
CREATE TABLE Klient (
    Id        INT PRIMARY KEY,
    Nazwa     NVARCHAR(100),
    Email     NVARCHAR(100),
    Pesel     NVARCHAR(11)
);

CREATE TABLE Zamowienie (
    Id        INT PRIMARY KEY,
    KlientId  INT REFERENCES Klient(Id),
    Numer     NVARCHAR(20),
    Data      DATE
);

CREATE TABLE PozycjaZamowienia (
    Id            INT PRIMARY KEY,
    ZamowienieId  INT REFERENCES Zamowienie(Id),
    Produkt       NVARCHAR(100),
    Ilosc         INT
);

INSERT INTO Klient VALUES (1, 'Jan Kowalski', 'jan@example.com', '80010112345');
INSERT INTO Zamowienie VALUES (10, 1, 'ZAM/2026/001', '2026-09-01');
INSERT INTO PozycjaZamowienia VALUES (100, 10, 'Monitor', 2), (101, 10, 'Klawiatura', 1);
Struktura danych
Utwórz strukturę z trzema poziomami rekordów:
Klient                  (adnotacja: tabela = Klient)
 ├─ Id, Nazwa, Email, Pesel
 └─ Zamowienia (lista)  (adnotacja: tabela = Zamowienie)
     ├─ Id, Numer, Data
     └─ Pozycje (lista) (adnotacja: tabela = PozycjaZamowienia)
         └─ Id, Produkt, Ilosc
Ważne elementy:
- Adnotacje z nazwą tabeli na każdym rekordzie. To one powinny się pojawić w wyniku jako parametry.
- Dodatkowo, dla sprawdzenia mapowań: dodaj w rekordzie Klient pole wyliczane albo kopiowane, np. NazwaWyswietlana jako kopię z Nazwa. Wtedy zobaczysz, czy operacja pokazuje informację o kopii i jej źródle.
- Opcjonalnie: oznacz adnotacją pola wrażliwe (Email, Pesel), np. jako dane osobowe. Pozwoli to później odfiltrować pola do anonimizacji.
Mapowanie
- Wczytanie danych: klient o Id = 1 razem z zamówieniami i pozycjami.
- Dodaj adnotację Klucz główny na polach Id (rekordu głównego oraz rekordów Zamowienia i Pozycje) – pozwoli to zweryfikować adnotację
APrimaryKeyw wyniku operacji. - Dodaj operację Kopia wartości z pola kopiującą Nazwa do nowego pola NazwaWyswietlana – pozwoli to zweryfikować adnotację
ACopy. - Na polu Zamowienia\Data dodaj operację wyliczającą wartość wyrażeniem, np.
= DateTimeNow()– pozwoli to zweryfikować adnotacjęAExpression. - Na końcu dodaj operację Introspekcja poddrzewa – UNPIVOT DRZEWA na poziomie całego rekordu (ścieżka
\).
- Opcjonalnie: filtr, który zostawia tylko pola z adnotacją danych osobowych.
Czego się spodziewać
Operacja tworzy rekord UnpivotTree z listą, w której każdy wiersz odpowiada jednemu rekordowi poddrzewa (Klient, Zamowienia, Pozycje), wraz z zagnieżdżoną listą Fields opisującą pola tego rekordu.
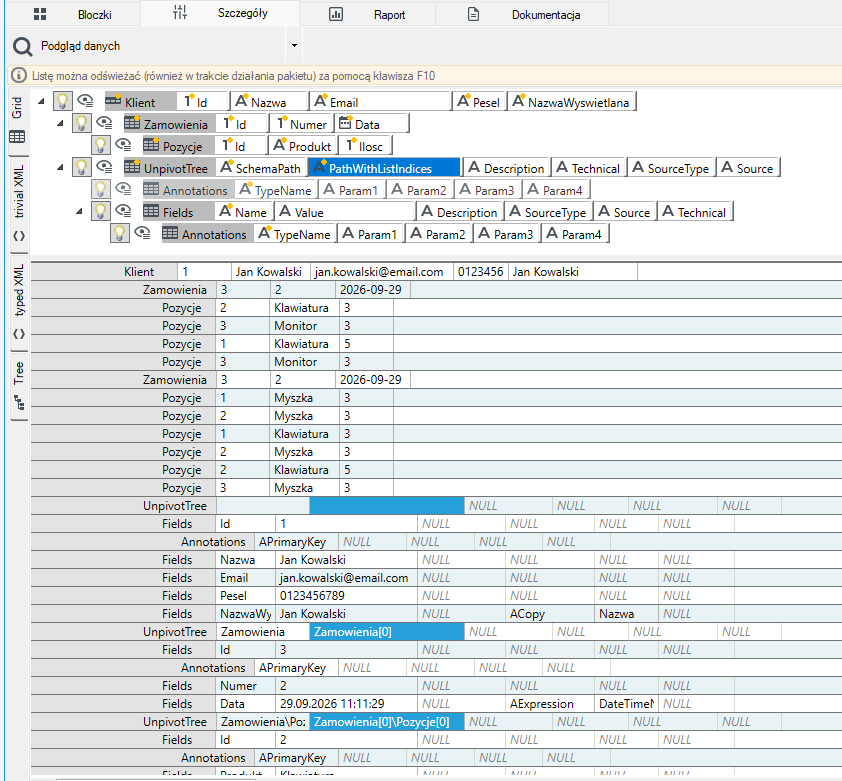
Na zrzucie widać m.in.:
- SchemaPath wskazujący ścieżkę rekordu bez indeksów list, np.
Zamowienia,Zamowienia\Pozycje, - PathWithListIndices – tę samą ścieżkę wraz z indeksami, np.
Zamowienia[0],Zamowienia[0]\Pozycje[0], - adnotację APrimaryKey na polach Id,
- SourceType = ACopy i Source = Nazwa na polu NazwaWyswietlana – potwierdza to, że operacja rzeczywiście pokazuje informację o kopiowaniu wartości i jej źródle,
- SourceType = AExpression i Source = DateTimeNow() na polu Data, co wskazuje, że wartość pola jest wyliczana wyrażeniem.
Pola Email i Pesel z rekordu Klient to gotowy materiał do wygenerowania skryptu anonimizacji, np. UPDATE Klient SET Email = ..., Pesel = ....
Przykład: anonimizacja danych historycznych
Problem: trzeba zanonimizować dane w tabelach historycznych VBP, które obejmują dziesiątki przypadków biznesowych i setki tabel. Tradycyjnie wymagałoby to bardzo wielu operacji mapowania, osobno dla każdego przypadku.
Rozwiązanie z Introspekcją poddrzewa – UNPIVOT DRZEWA:
- Wczytaj drzewo danych.
- Wykonaj operację Introspekcja poddrzewa – UNPIVOT DRZEWA. Powstanie lista rekordów i pól razem z nazwami tabel wyciągniętymi z adnotacji.
- Kolejnymi operacjami mapowania wybierz potrzebne elementy, np. pola do anonimizacji i ich źródła, a resztę odrzuć.
- Na tej podstawie uruchom jeden skrypt SQL, który anonimizuje dane we wszystkich tabelach historycznych.
Efekt: kilka operacji mapowania i jeden skrypt SQL zamiast setek lub tysięcy operacji tworzonych ręcznie.