Czym są Mapowania
Logika Mapowań (Odwzorowanie w miejscu, SMIP) jest wykorzystywana w wielu miejscach platformy VSoft archITekt.
Mapowania wykorzystywane są w Interfejsie Użytkownika podczas tworzenia formularzy na zakładce Mapowania startowe, a także jako edytor odwzorowania w miejscu (mapowania w miejscu) w Pakietach Przetwarzania Danych.
W dokumentacji mogą być stosowane zamiennie określenia dla Mapowań jako Odwzorowanie w miejscu (SMIP), a także takie jak edytor odwzorowania w miejscu (designer Mapowań), itp.
Odwzorowanie w miejscu (zwane pokrótce SMIP = ang. Schema mapping In-place) jest określone za pomocą listy operacji do wykonania. Dostępne operacje dzielą się na zmieniające wyłącznie schemat (nie zajmujące czasu w trakcie przetwarzania!) i zmieniające treść rekordów danych. Operacje do wykonania dodajemy korzystając z menu kontekstowego i przypisując do pola/ rekordu adnotację. Patrz: Adnotacje.
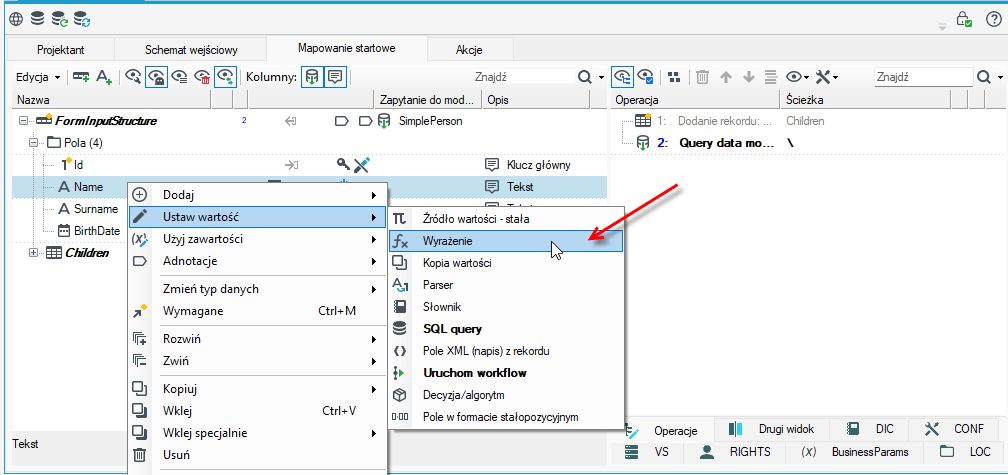
Element odwzorowania w miejscu (SMIP) występuje jako część składowa bardzo wielu bloczków przetwarzających, w tym m.in:
- Odwzorowanie w miejscu (wszystkie opcje operacji dostępne)
- Zapis do bazy (dodatkowo w celu wstawienia adnotacji charakterystycznych dla bazy)
- Zapis do XML (j.w. w celu wstawienia adnotacji odwzorowania do XML)
- Normalizator (w celu wstawienia przepisu normalizacji)
Jak każde przetwarzanie rekordów, logika SMIP składa się z dwóch elementów:
- przetwarzania schematów - zmienia schemat danych wejściowy w wyjściowy, po drodze wytwarzając dodatkowe opisy potrzebne do szybszego wykonania przetwarzania w fazie Masowego Przetwarzania Danych, a także wykonuje walidację zdefiniowanych operacji (np. wymagalność pól, poprawność wyrażeń, dostępność odwołań do słowników itp.). Ta faza wykonywana jest wielokrotnie w trakcie pracy w designerze, przed uruchomieniem na danych przebiega tylko raz
- przetwarzania rekordów - odbywa się oddzielnie dla każdego rekordu wejściowego, dlatego jest mocno zoptymalizowane.
Designer dla Mapowań
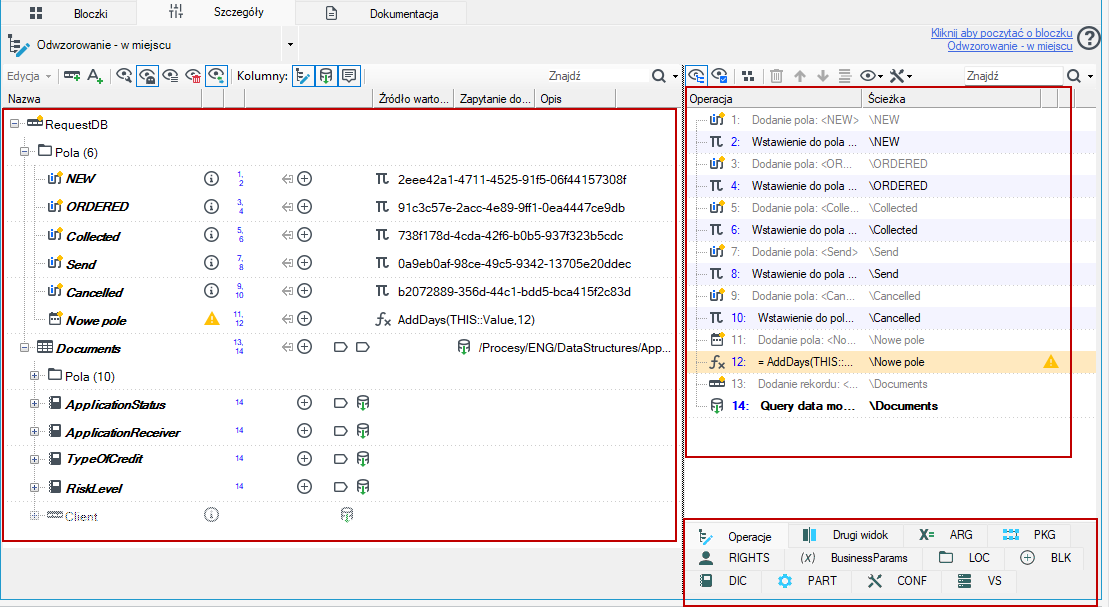
Składa się z dwóch paneli:
Lewy - prezentuje tylko schemat danych. Schemat danych zorganizowany jest w formie drzewka. Więcej patrz: Schemat danych.
Zestaw zakładek widoczny w prawym panelu jest różny i zależny od tego czy designer mapowań jest otwarty w kontekście formularza czy pakietów przetwarzania.
Prawy – zawiera zakładki:
- Operacje – więcej patrz: Operacje.
- Drugi widok schematu danych (przydatny do unikania przewijania zawartości w przypadku dużych schematów),
- ARG: zawiera drzewo danych argumentów wywołania pakietu więcej patrz: Argumenty wywołania pakietu.
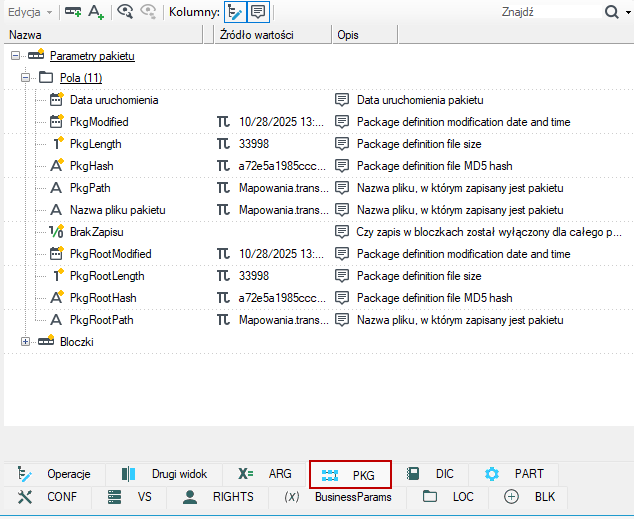
- PKG: zawiera wartości parametrów elementów pakietu (np. czas rozpoczęcia przetwarzania) i jego składowych (np. szczegóły poszczególnych bloczków),
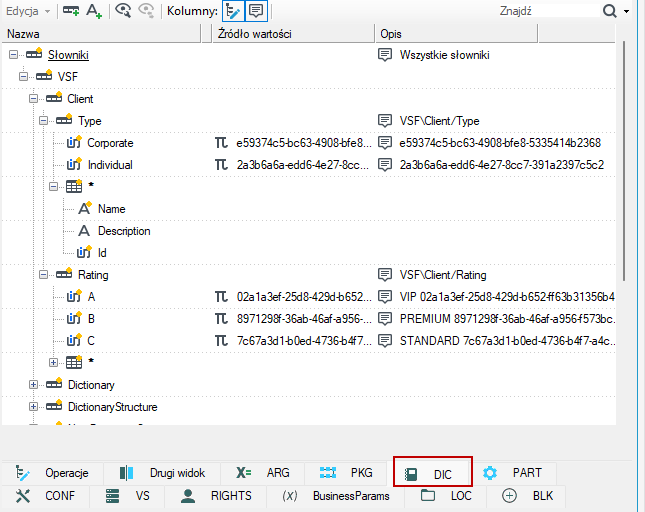
- DIC: lista dostępnych słowników wraz z kolumnami,
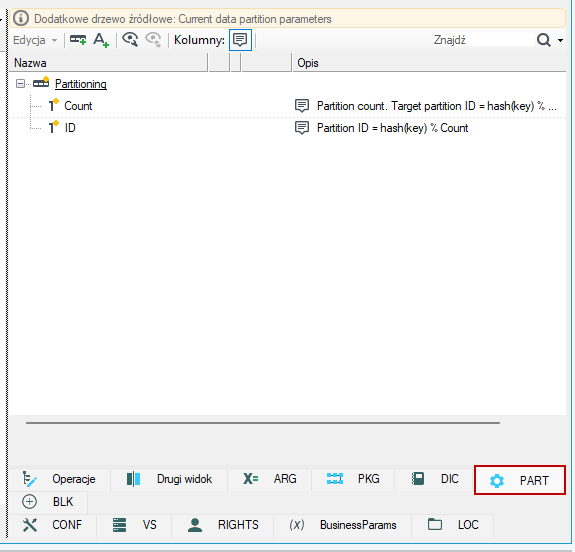
- PART: Aktualne parametry partycji danych
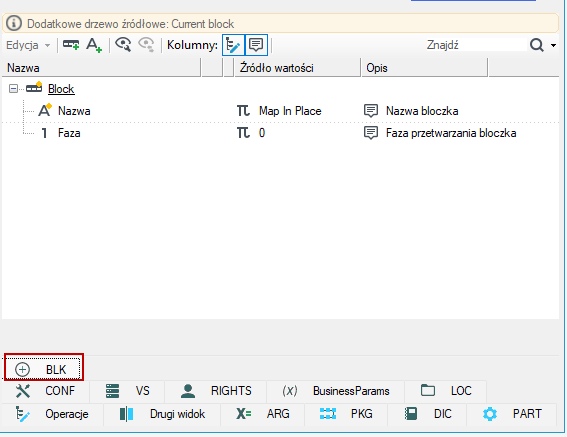
- BLK: dane aktualnego bloczka.
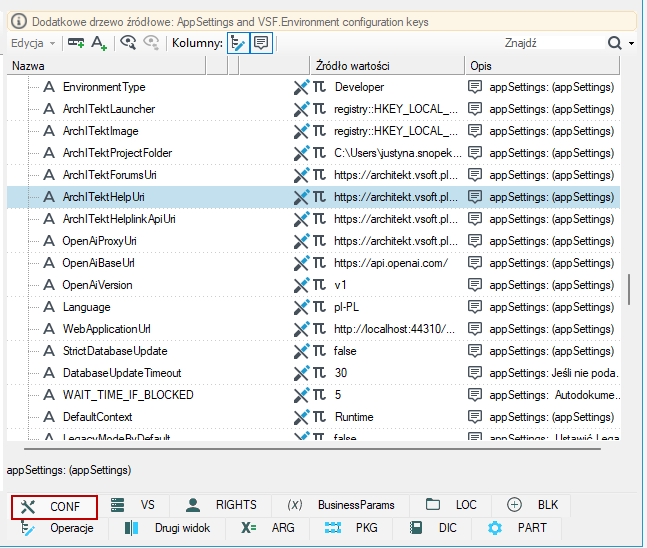
- CONF: Klucze konfiguracyjne dostępne z poziomu konfiguracji głównej (appSettings), pliku .ini i pozostałych źródeł konfiguracji technicznej. Komentarz każdego elementu wskazuje na źródło klucza.
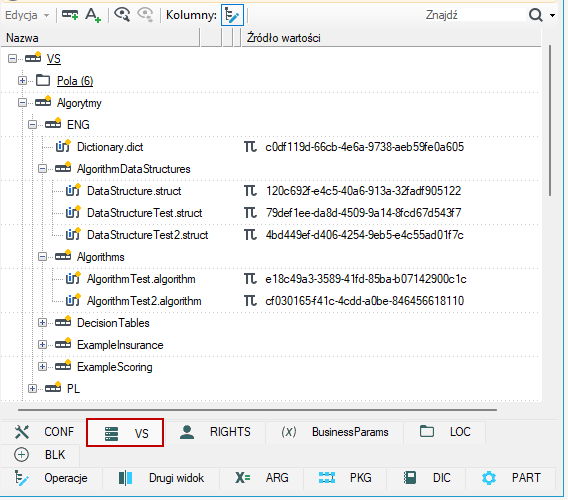
- VS: Drzewko z zawartością serwera wersji wraz z GUIDEM każdej wersji
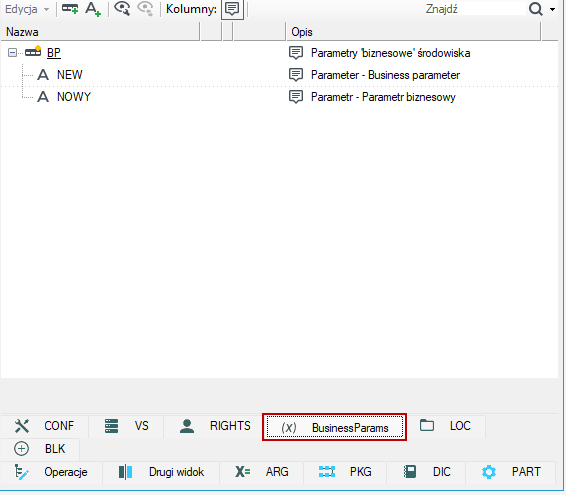
- BusinessParam: drzewko parametrów biznesowych jeżeli zostały zdefiniowane – o definiowaniu parametrów biznesowych patrz: Parametry biznesowe
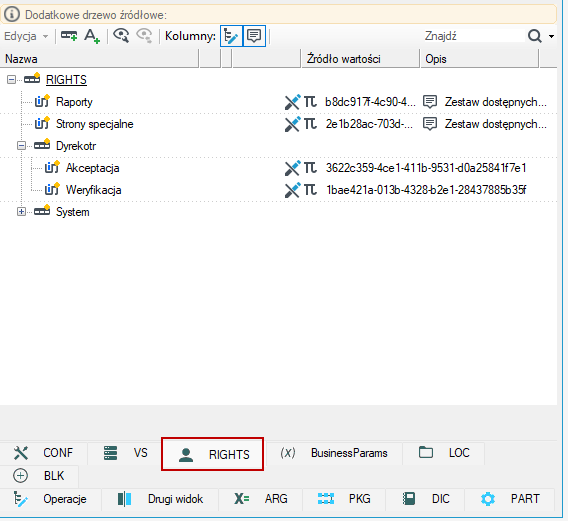
- RIGHTS: lista stron specjalnych zdefiniowanych w archITekt Studio oraz systemowych
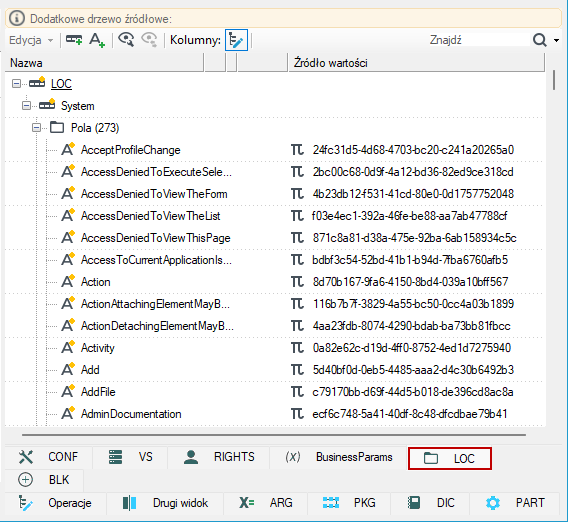
- LOC: lista zmiennych lokalnych zdefiniowanych w archITekt Studio
Zakładki ARG, PKG, BusinessParams, RIGHTS, DIC, PART, CONF, VS, LOC reprezentują drzewa nazwane. Przeciąganie elementów drzew nazwanych z tych zakładek na elementy schematu danych na lewym panelu edytora powoduje dodanie do elementu docelowego adnotacji Wyrażeniei ustawienie przeciąganego elementu źródłem wartości wyrażenia.