Narzędzia projektowe
Rozdział zawiera szczegółowy opis bloczków stanowiących narzędzia projektowe.
Bloczki zostały umieszczone po lewej stronie okna w menu Przybornik.
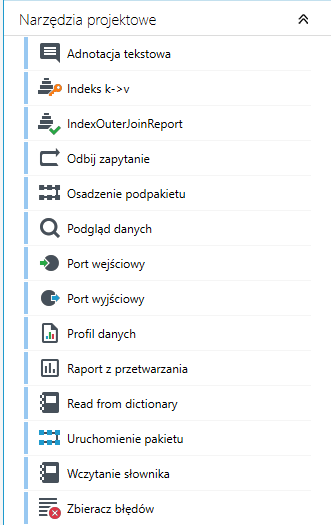
Należą do nich:
- Podgląd danych
- Wczytanie słownika
- Zbieracz błędów
- Indeks k->v
- IndexOuterJoinReport
- Osadzenie podpakietu
- Port wejściowy
- Port wyjściowy
- Profil danych
- Uruchomienie pakietu
- Raport z przetwarzania
- Odbij zapytanie
- Adnotacja tekstowa
Podgląd danych

Bloczek Podgląd danych jest narzędziem projektowym służącym do podglądu wyników danej operacji.
- Użytkownik w celu podglądu wyników operacji umieszcza bloczek Podgląd danych w wymagane miejsce.
- Przeglądanie wyników odbywa się z widoku zakładki Szczegóły.
Do dyspozycji mamy cztery różne widoki tych samych danych (zwykle ostatnie np. 1000 rekordów przepływających przez bloczek).
- Podstawowy widok siatki-drzewa
- Widok prostego XML
- Widok XML bazującego na metadanych sterujących formatowaniem XML, wykorzystywanymi w innych operacjach mapowania XML, np. zwracaniu danych z usługi, formatowaniu pola XML czy zapisie do pliku XML. Widok ten może ukrywać niektóre informacje.
- Widok drzewa danych uzupełnionego o kolumny z wartościami z poszczególnych rekordów.
W tym widoku widać jedynie pierwsze z ewentualnych wielu rekordów-dzieci.
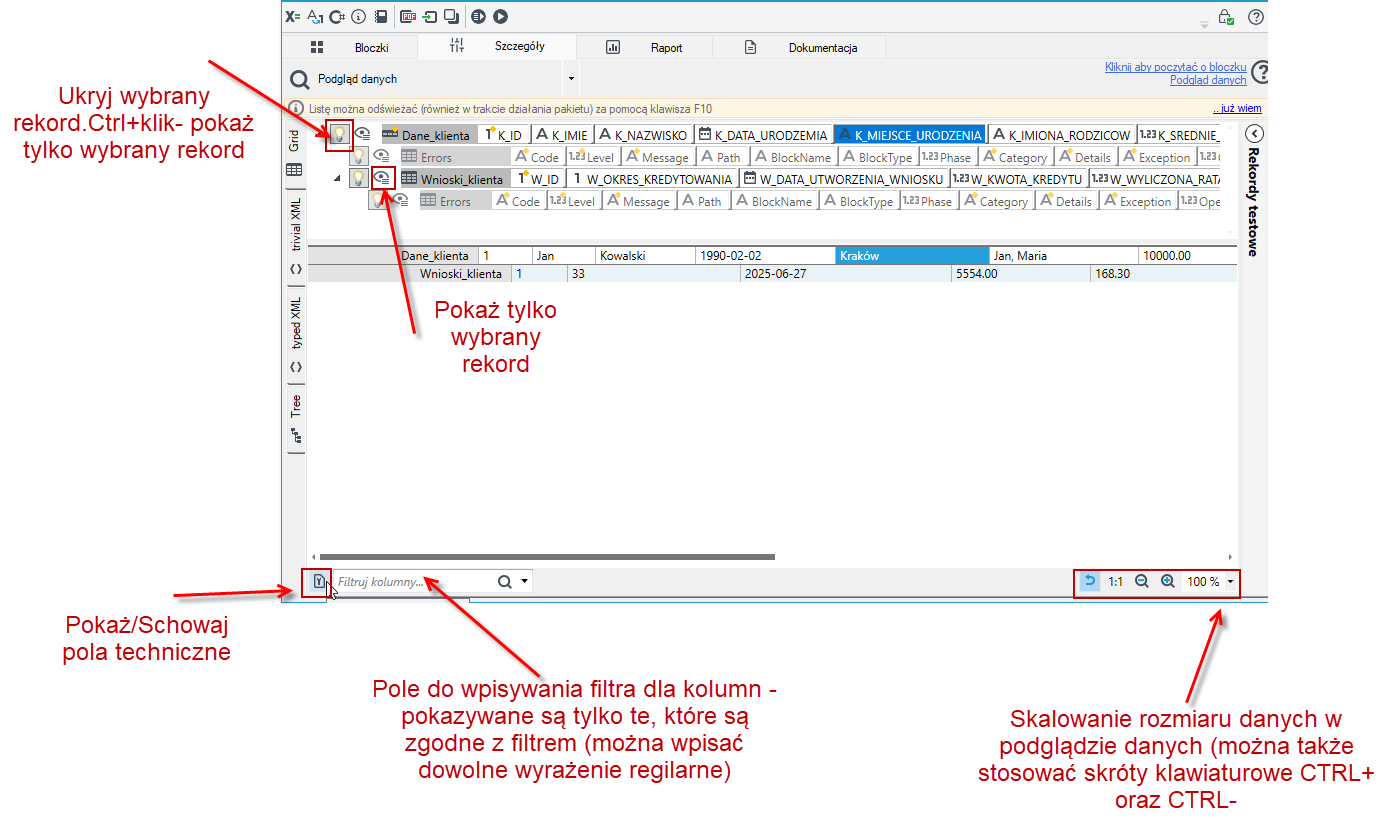
Kontrolka podstawowego widoku siatki-drzewa do podglądu danych oferuje dużą ilość możliwości ułatwiających korzystanie z podglądu, poniżej rysunek prezentujący te możliwości:
Wczytanie słownika

Bloczek Wczytanie słownika pozwala na ładowanie rekordów z wejścia i tworzenia z nich indeksu. Umożliwia następnie ich odpytywanie.
Bloczek wczytuje rekordy przygotowane z wcześniejszego przetwarzania jako słownik. Słownik ten może być wykorzystany w dalszej części przetwarzania (przy użyciu adnotacji Słownik).
Zbieracz błędów

Bloczek Zbieracz błędów jest narzędziem niezależnym, odpowiedzialnym za funkcje gromadzenia błędów z wszystkich bloczków danej fazy.
Zastosowanie polega na umieszczeniu bloczka w pakiecie wymagającym sprawdzenia pod względem pojawiających się błędów.
Poniżej przedstawiono przykład zastosowania w pakiecie przetwarzania:
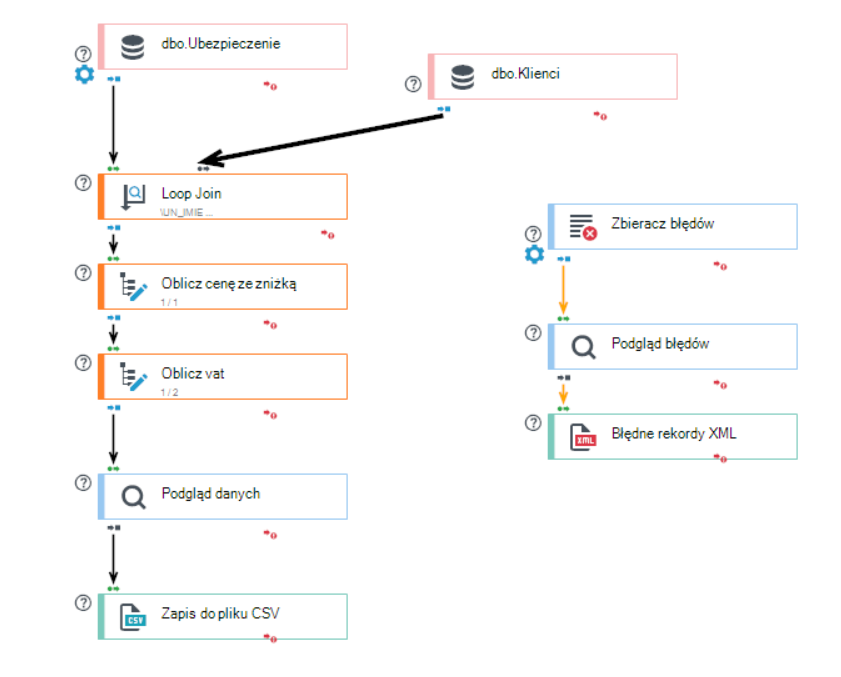
Bloczek może być traktowany jak każdy inny bloczek wejściowy - rekordy z niego wychodzące mogą być przetwarzane tak jak inne rekordy (bloczek powinien mieć zatem ustawioną liczbę wątków większą od 0 oraz fazę przetwarzania taką samą jak podgraf spójny, który ma zostać sprawdzony). Dodatkowo w szczegółach bloczka możesz wskazać bloczki, z których zbierane będą błędy.
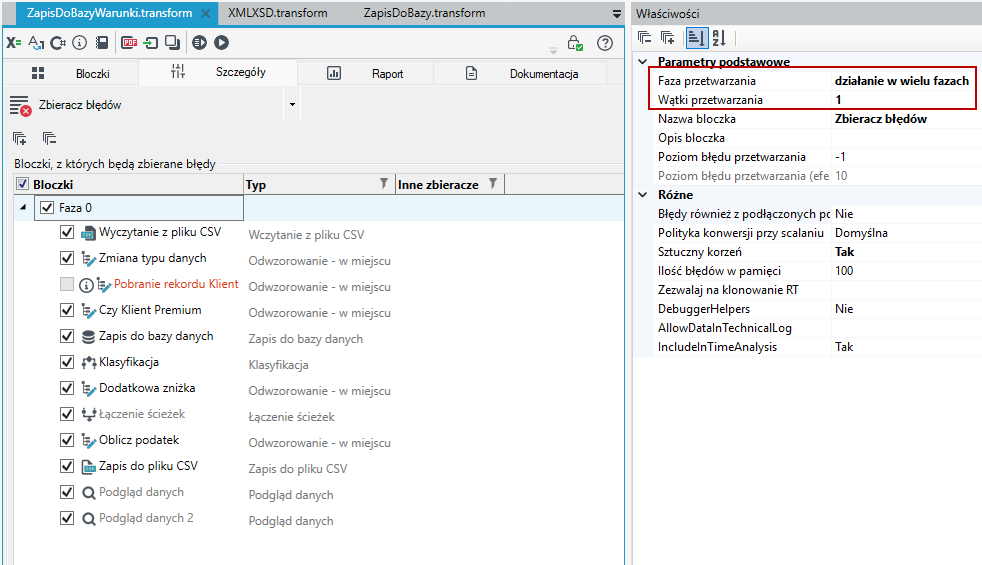
Za pomocą odpowiedniego bloczka wyjściowego lista z wyszukanymi błędami zostanie zapisana w odpowiednim formacie we wskazanym przez Użytkownika miejscu bądź przedstawiona w podglądzie danych.
Indeks k->v

Bloczek Indeks k->v umożliwia indeksowanie przechodzących rekordów po wybranym przez użytkownika kluczu.
Funkcja stosowana jest przy przetwarzaniu plików o dużych wolumenach danych.
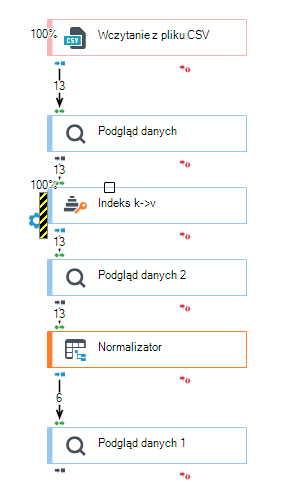
Szczegóły bloczka podzielone zostały między trzy zakładki.
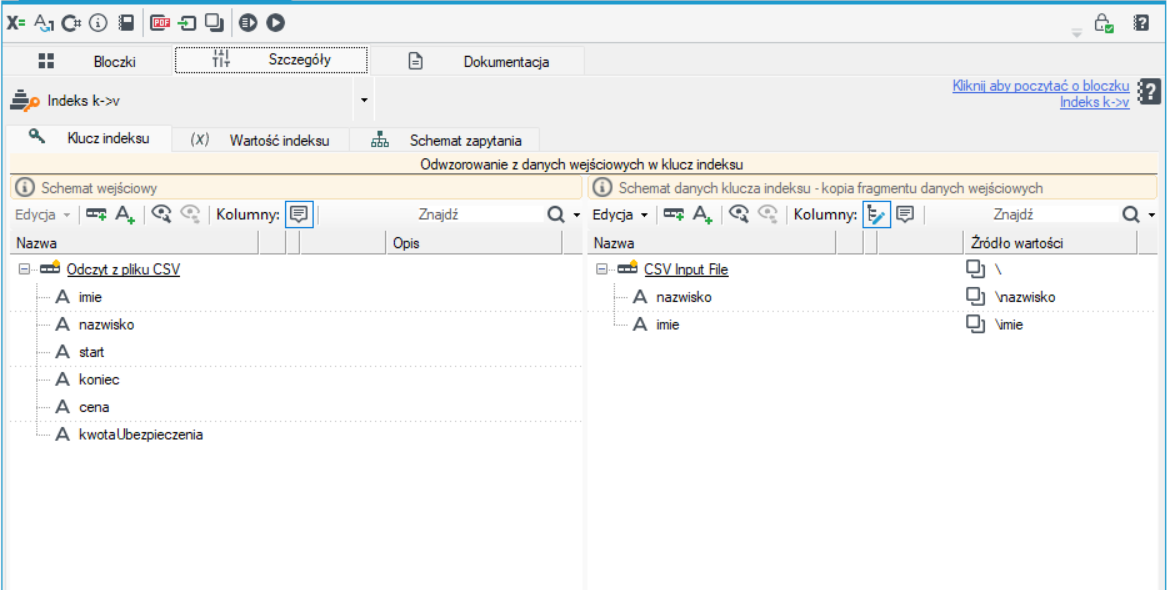
Zakładka Klucz indeksu umożliwia Użytkownikowi podanie, który element będzie stanowił klucz indeksu. W tym celu z lewej części okna, stanowiącego podgląd schematu pliku wejściowego, należy przeciągnąć odpowiedni element do okna po stronie prawej.
Przeciągnięty element oznaczony zostanie jako klucz indeksu.
Zakładka Wartość indeksu stanowi podgląd schematu pliku wejściowego bloczka (okno po lewej stronie) - umożliwia określenie, jakie informacje mają być zapisywane wraz z kluczem indeksu (okno po prawej).
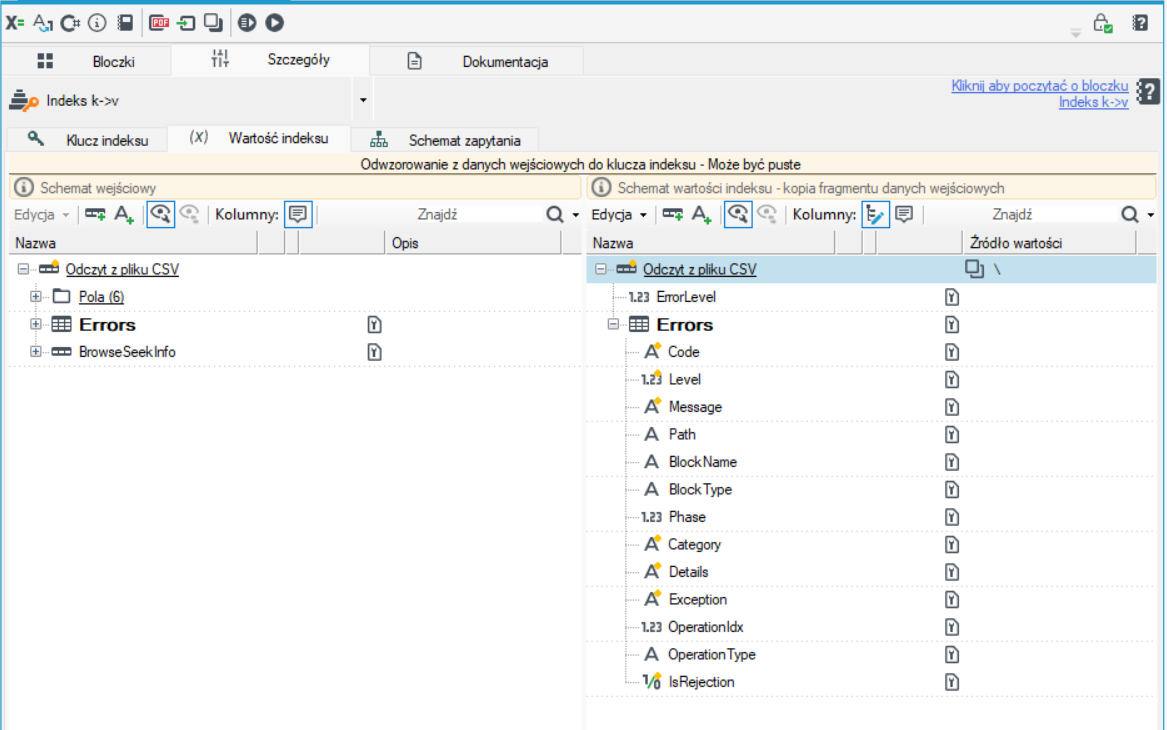
Operowanie na poszczególnych elementach danych zostało szczegółowo opisane w rozdziale poświęconym dostosowywania schematów rekordów oraz pól - patrz: Przetwarzanie danych.
- Wartość indeksu nie musi być podawana w (domyślnym) trybie działania bloczka - sortowania elementów w buforze.
- Wówczas składowane będą całe rekordy wejściowe, co jest najczęściej pożądanym rozwiązaniem w tym trybie pracy, prowadzi też do lepszej wydajności niż w przypadku wykonywania odwzorowania.
- Wcześniejsze wersje bloczka wymagały podawania mapowania do wartości indeksu, obecnie system będzie ostrzegał o możliwej do wykonania optymalizacji (usunięciu mapowania) jeśli wykryje mapowanie przynajmniej 50% pól schematu wejściowego.
Sortowanie zewnętrzne
Przetwarzania danych wspiera sortowanie zbiorów danych, których wielkość przekracza ilość dostępnej pamięci operacyjnej.
- Aplikacja sortując takie rekordy, tworzy na dysku twardym pliki tymczasowe (domyślnie są one tworzone w katalogach tymczasowych systemu Windows). Należy zatem zadbać, aby na dysku twardym było wystarczająco wolnego miejsca.
- Aby skorzystać z wyżej opisanej możliwości, w panelu Właściwości zaznacz opcję Sortowanie zewnętrzne (aby opcja była aktywna, dla atrybutu Tryb pracy musi być wybrana opcja Składowanie rekordów przechodzących).
Aby zmienić domyślny katalog dla plików tymczasowych, należy ustawić opcję TempDirectory w pliku konfiguracyjnym aplikacji.
W tym trybie pracy bloczek wymaga podania tylko jednego odwzorowania: dane wejściowe → klucz indeksu.
Indeksowanie danych
W tym trybie zasada działania bloczka jest bardziej skomplikowana, umożliwia tłumaczenie zapytań i przesyłanie ich dalej, wymaga czasem aż 3 odwzorowań:
- co jest kluczem w danych oraz w zapytaniu po prawej stronie bloczka – zwykle kluczem biznesowym, np. numer umowy (D →K),
- co jest kluczem po lewej stronie bloczka – zwykle kluczem technicznym, np. offset w pliku lub ID w bazie (tak, prościej skorzystać z indeksu w bazie danych, gdy mamy bazę) (D →V),
- jak powinno wyglądać zapytanie wysyłane do wejścia bloczka w zależności od wartości (i klucza) składowanego w indeksie, dla wartości w zapytaniu oryginalnym pojawiającym się na wyjściu bloczka (K, V, Q) →Q` .
Symbolicznie można to zapisać następująco:
D – dane wejściowe do bloczka,
K – pola klucza biznesowego, występującego zarówno w danych wejściowych jak i w zapytaniu Q,
V – pola wartości, spamiętane dla każdego rekordu wejściowego, potrzebne do przygotowania zapytania Q`,
Q – zapytanie przychodzące z prawej strony bloczka,
Q` - zapytanie wychodzące z lewej strony bloczka, wytworzone na podstawie (K, V, Q).
Sposób działania będzie następujący:
- W pierwszym etapie działania w pamięci budowane jest mapowanie K →V, w tym celu są odczytywane wszystkie rekordy wejścia.
- W drugim etapie, w zależności od tego, czy bloczek otrzymuje zapytania, czy nie.
- Bloczek nie otrzymuje zapytań Q Bloczek nie potrzebuje trzeciego odwzorowania, wykonuje kolejno zapytania Q` na podstawie wartości indeksu spod kolejnych kluczy, zwracając wyniki na port wyjściowy.
- Bloczek otrzymuje zapytania Q
Jest wykonywane mapowanie (K→V) a następnie (K, V, Q) → Q`, a jego wynik zwraca na port wyjściowy.
Przykład wykorzystania bloczka patrz: Normalizacja i sortowanie danych.
IndexOuterJoinReport

Bloczek IndexOuterJoinReport
Osadzenie podpakietu

Osadzenie podpakietu jest szczególnym bloczkiem, gdyż pozwala on na dołączenie i wywoływanie na przetwarzanych danych wcześniej przygotowanej w formie osobnego pakietu transformacji.
Bloczek umożliwia wyłączenie reużytkowalnych fragmentów grafów (czyli np. połączonych grup bloczków) do oddzielnych pakietów (podpakietów) i włączanie ich w stosowne miejsca.
W momencie uruchomienia bloczki podpakietów są osadzane w pakiecie wywołującym. Jest to zupełnie inne zachowanie niż to oferowane przez inny bloczek Uruchomienie pakietu przetwarzania.
Typowe zastosowania dla podpakietów to:
- deklaracja wspólnych słowników,
- wyłączenie wspólnej logiki (np. wyliczanie agregatów).
Ścieżkę do podpakietu, który ma być wywoływany wybieramy ustawiając właściwość Ścieżka do podpakietu w panelu Właściwości:
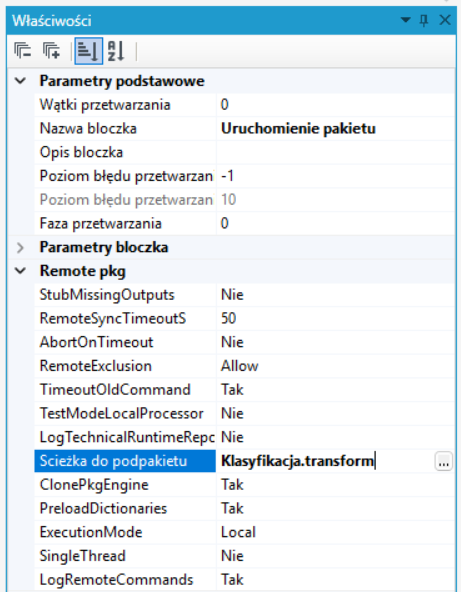
Należy przy tym zwrócić szczególną uwagę na to, że zapamiętana ścieżka do podpakietu jest względna w stosunku do ścieżki dla całego pakietu – jeśli pakiet zostanie przeniesiony w inne miejsce, podpakiet musi się znaleźć w analogicznym jak wcześniej położeniu w stosunku do pakietu.
Ogólne uwagi
Poniżej kilka uwag, o których należy pamiętać przy projektowaniu pakietów wraz z podpakietami:
Słowniki
- W celu uniknięcia konfliktów, które mogłyby się pojawić w przypadku nazw słowników (jeśli np. podpakiet z ładowaniem słowników zostałby dołączony kilkakrotnie), nazwy słowników mają dodawany prefiks będący nazwą podpakietu – przykładowo jeśli słownik o nazwie Waluty jest ładowany w bloczku Osadzenie podpakietu o nazwie Ładuj słowniki, to w pakiecie głównym będzie on miał nazwę Ładuj słowniki\Waluty.
Nazwy bloczków
- Podobnie jak w przypadku nazw słowników, także nazwy bloczków podczas ładowania ich w ramach podpakietu otrzymują przy swojej nazwie prefiks z nazwą podpakietu (należy na to zwrócić uwagę np. w panelu Komunikaty projektowe, gdzie jest podawana nazwa bloczka, w którym wystąpił jakiś problem np. błąd lub ostrzeżenie).
Budowanie podpakietu
- Tworzenie podpakietu wygląda prawie identycznie, jak tworzenie każdego innego pakietu. Jedyna różnica, która występuje to sposób definiowania wejścia i wyjścia podpakietu.
- Do definicji struktury danych wejściowych /wyjściowych służą odpowiednio bloczki Port wejściowy oraz Port wyjściowy, które można znaleźć w przyborniku w zakładce Narzędzia projektowe.
Port wejściowy pozwala zdefiniować minimalną strukturę danych jaka jest wymagana, aby podpakiet mógł być poprawnie wykonany – oznacza to, że dane które zostaną dostarczone do podpakietu mogą mieć dowolną postać. Najważniejsze aby posiadały pola i rekordy wymagane przez port wejściowy.
Podobnie, w przypadku portu wyjściowego – jedyna różnica polega na tym, że port ten pozwala na definicję minimalnego schematu zapytania, jakie musi być do niego dostarczone, gdyż schemat wyjściowy przetwarzania jest definiowany przez schemat wejściowy dostarczony do podpakietu oraz zaprojektowane w nim transformacje.
Port wejściowy

Bloczek jest wykorzystywany do definiowania podpakietów. Szczegółowe informacje o jego wykorzystaniu znajdują się w opisie bloczka Osadzenie podpakietu.
Port wyjściowy

Bloczek wykorzystywany do definiowania podpakietów. Szczegółowe informacje o jego wykorzystaniu znajdują się w opisie bloczka Osadzenie podpakietu.
Profil danych

Bloczek Profil danych służy do profilowania danych i wyciągania z nich odpowiednich informacji, takich jak np. monotoniczność danych, rodzaj i format danych, itd.
Funkcja generuje plik – raport z profilu danych, zapisywany we wskazanym przez Użytkownika miejscu w oknie wartości uruchamiania wniosku wyświetlanym przed uruchomieniem pakietu.
Poniżej przykładowy pakiet przetwarzania z użyciem omawianego narzędzia projektowego:
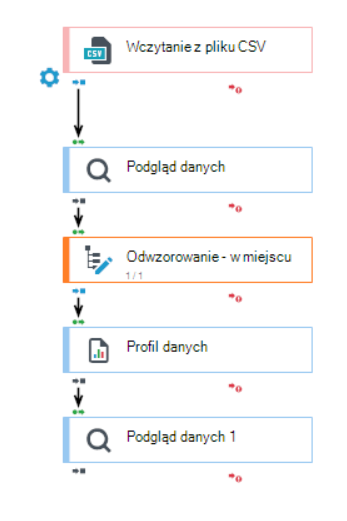
Za pomocą odpowiedniego bloczka wyjściowego profil danych zostanie zapisany w odpowiednim formacie we wskazanym przez Użytkownika miejscu, bądź przedstawiony w podglądzie danych.
Wygenerowany dokument z profilem danych zawiera następujące informacje:
- ilość przetworzonych rekordów z podziałem na typ danych,
- lista rekordów i pól z opisem,
- Ilość oraz procent pustych pól,
- ilość różnych wartości,
- informacja o przekroczeniu limitu 300 różnych wartości dla każdego pola,
- minimalna oraz maksymalna wartość,
- typ porównywania,
- monotoniczność,
- ilość liczb stałopozycyjnych, z kropką, z przecinkiem, dat, typu bool,
- maksymalna długość,
- maksymalna precyzja liczb stałopozycyjnych,
- maksymalna skala liczb z kropką,
- maksymalna skala liczb z przecinkiem.
Uruchomienie pakietu

Bloczek Uruchomienie pakietu pozwala na wywołanie kompletnego innego pakietu przetwarzania bez osadzania jego bloczków w miejscu wywołania (jak robił to bloczek Osadzenie podpakietu).
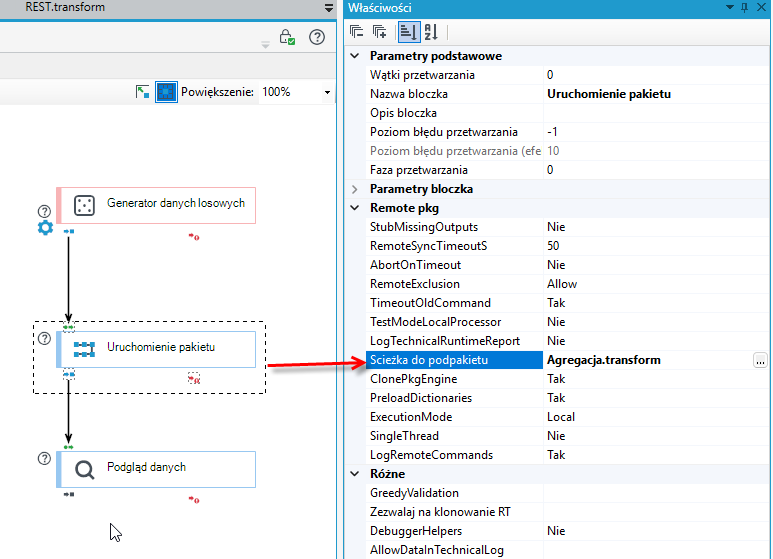
- Konfiguracja wywołania wymaga wskazania w parametrach pakietu do wywołania (lub tylko jego szablonu używanego w momencie projektowania – dla załadowania danych wejściowych).
- Następnie należy wskazać punkt startowy wywołania (Wybierz korzeń) oraz zmapować dane wejściowe, takie jak argumenty startowe pakietu czy wartości parametrów bloczków (np. ścieżek do plików wejściowych i wyjściowych).
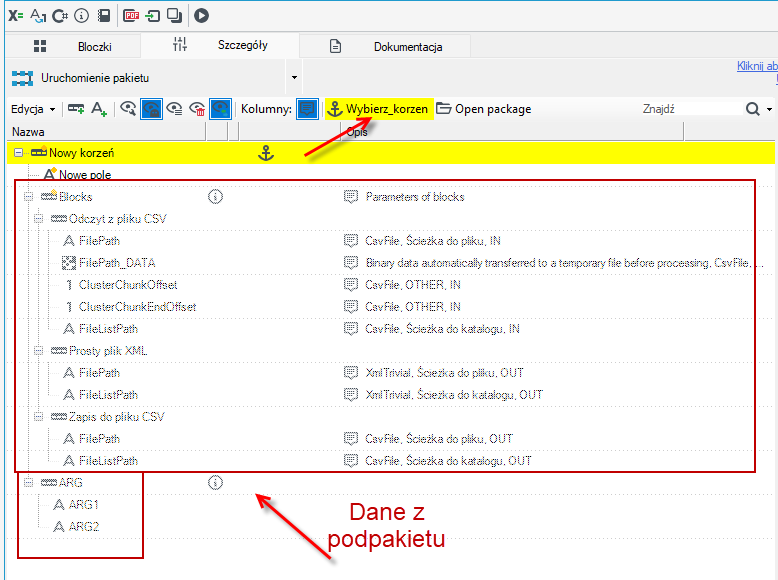
- Konfiguracja ta jest analogiczna jak w przypadku bloczków Uruchom algorytm, Utworzenie dokumentu, Wywołaj usługę WCF.
Warto wspomnieć dwa typowe zastosowania bloczka Uruchomienie pakietu:
- Opakowanie go w usługę web-service wywoływaną np. przez aplikację WWW w celu wykonania dużego przetwarzania danych na żądanie, zwykle z uprzednim pobraniem treści danych do przetworzenia z bazy na dysk (do katalogu tymczasowego) i rejestracja stanu /logów przetwarzania z powrotem do bazy.
- Wywoływanie go na podstawie listy rekordów czytanych z bazy danych lub katalogu z plikami w celu kolejnego przetworzenia wielu plików / obiektów BLOB.
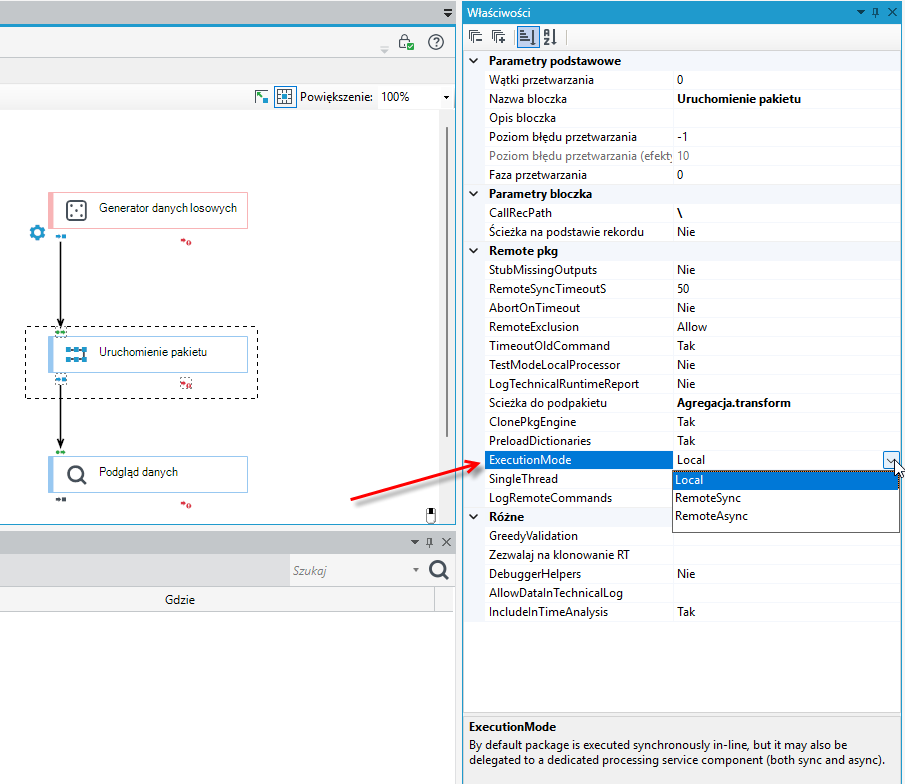
Execution mode:
- Local - domyślnie pakiet jest uruchamiany synchronicznie i wykonywany "tu i teraz" w tym samym silniku, docelowo ze współdzieleniem kontekstu użytkownika, kontekstów danych, kontekstu usługi WCF i wszystkich innych. Wywołujący musi poczekać na wyniki. Ewentualne ścieżki do fizycznych plików muszą działać lokalnie, log z wykonania trafia do wywołującego bezpośrednio.
- RemoteSync oznacza "zapisz zlecenie wykonania pakietu do kolejki i poczekaj aż zostanie: (potencjalnie na innej maszynie, a na pewno w innym procesie) podjęta praca, przetworzone dane zlecenie i zwrócone wyniki. Taki scenariusz nie będzie szybko działać. Jes to wykonanie w innym silniku, docelowo na dużej puli workerów, ze współdzieleniem tylko kontekstu użytkownika. Należy mieć z tyłu głowy, że mamy tu do czynienia z działaniem rozproszonym ze wszystkimi potencjalnymi konsekwencjami. Ewentualne binarne dane do/z bloczków typu IO (z parametrami FilePath) są przemycane przez centralną tabelę z polem BLOB.
- RemoteAsync działa jak powyżej, ale nie czeka na koniec przetwarzania, jedynie dostaje ID do samodzielnego późniejszego monitorowania.
- Trybów Remote używamy raczej do zlecania przetworzenia jakichś dużych plików (lub generowania paczki dokumentów) w środowisku zdalnym poza WWW.
Pozostałe włściwości:
- RemoteSyncTimeoutS — limit czasu dla zdalnej synchronizacji (w sekundach). Po osiągnięciu tego progu wywołujący otrzyma komunikat o błędzie i opcjonalnie, zostanie podjęta próba przerwania pakietu. Zobacz: AbortOn Timeout.
- AbortOnTimeout — jeśli ustawiono dla trybu zdalnej synchronizacji (RemoteSync), silnik spróbuje przerwać działanie pakietu po osiągnięciu skonfigurowanego limitu czasu. Jeśli nie, pakiet będzie kontynuował działanie.
- TimeoutOldCommand — wykonuwanie żądań starszych niż określony próg zostaną odrzucone jako zbyt stare. Ustawienie Nie pozwala na ich nieograniczone kolejkowanie.
- RemoteExclusion — kontroluje, co dzieje się z poleceniami zdalnego wykonania, gdy wykryte zostanie inne polecenie tego samego typu (identyfikator pakietu).
Dynamiczne przypisywanie pakietu przetwarzania
- W treści danych potrzebnych do wywołania pakietu istnieje możliwość podania ścieżki do pakietu innej niż w momencie projektowania. Pozwala to na zdecydowanie o konkretnym wywoływanym pakiecie na etapie działania (a nie projektowania) na podstawie danych.
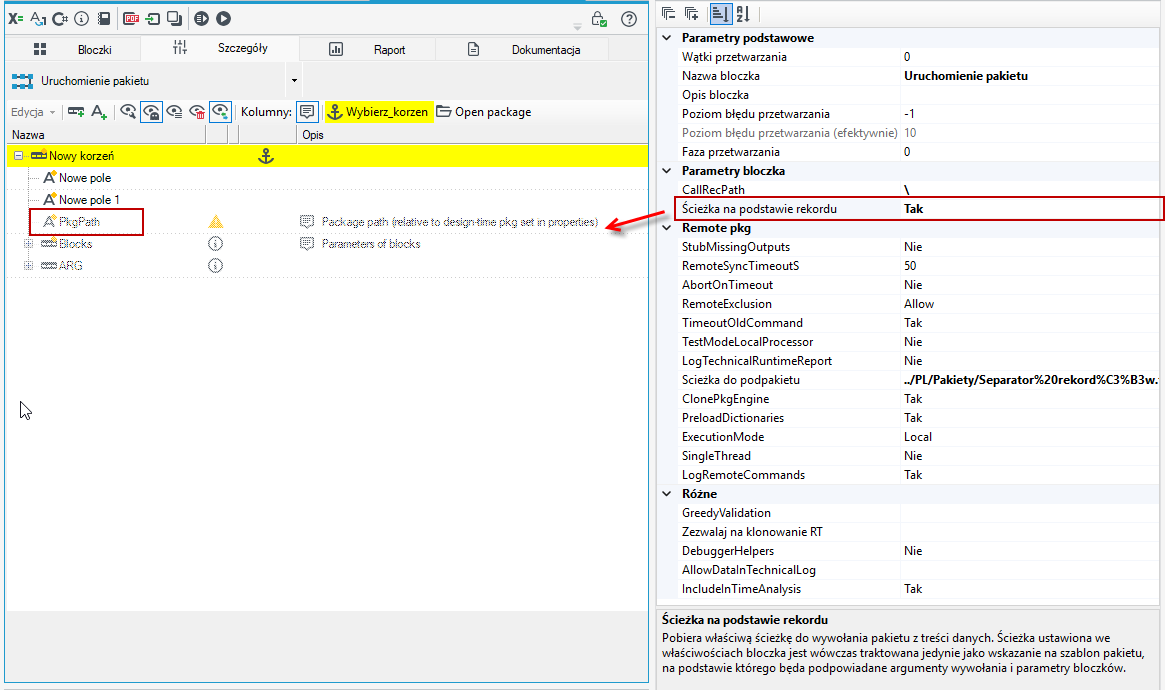
- Wybierz opcję Tak w polu Ścieżka na podstawie rekordu na panelu Właściwości.
- Po wykonaniu akcji na schemacie danych pojawi się pole do wypełnienia ścieżką do pakietu uruchomienia.
- Właściwość ta pobiera ścieżkę do wywołania pakietu z treści danych. Ścieżka ustawiona we właściwościach bloczka wcześniej (Ścieżka do podpakietu) jest wówczas traktowana jedynie jako wskazanie na szablon pakietu, na podstawie którego będą podpowiadane argumenty wywołania i parametry bloczków.
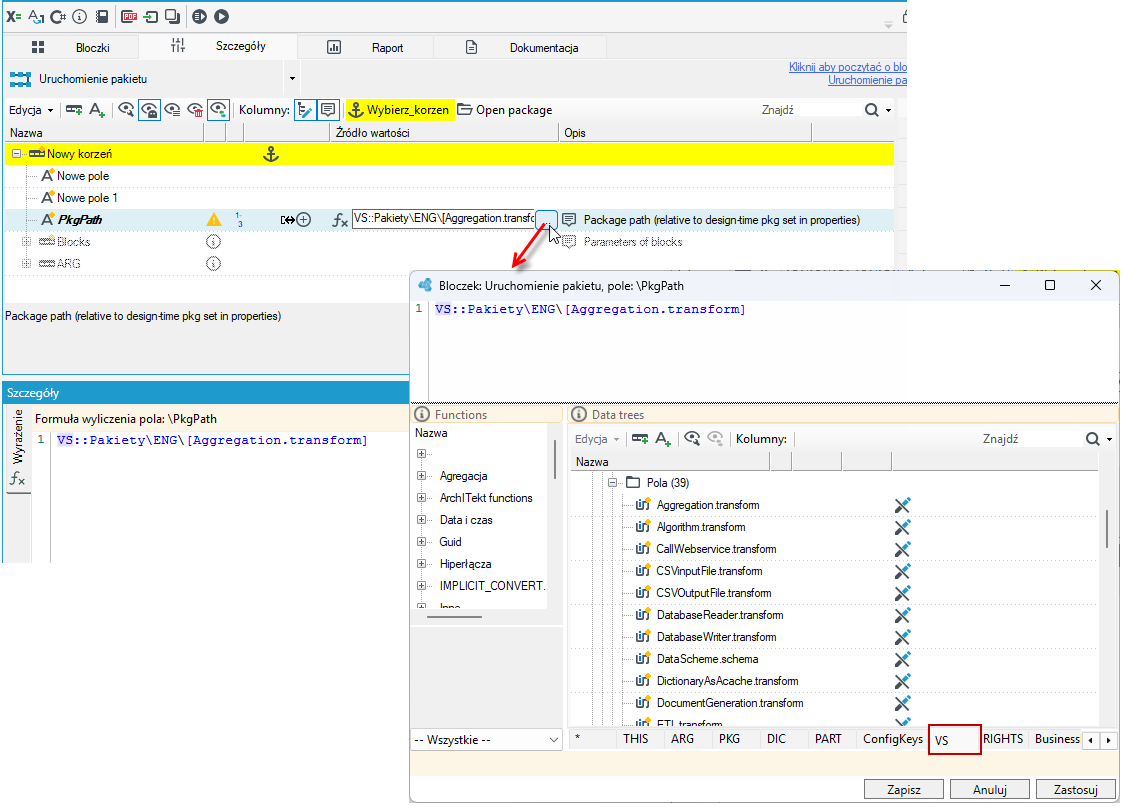
- Kolejno wybierając z menu kontekstowego opcje dodania pola do schematu oraz adnotację czy to wyrażenie czy stałą możesz określić ścieżkę absolutną lub względną.
Raport z przetwarzania

Bloczek Raport z przetwarzania jest narzędziem niezależnym, generującym raport z przetwarzania danych.
Raport generowany jest z niższych faz od fazy, w której się sam znajduje z następujących bloczków:
- Klasyfikacja,
- Podgląd danych,
- Profil Danych,
- Kosz.
Zastosowanie polega na umieszczeniu bloczka w zakładce z pakietem, z przetwarzania, którego raport ma zostać wygenerowany.
Poniżej przedstawiono przykład zastosowania w pakiecie przetwarzania:
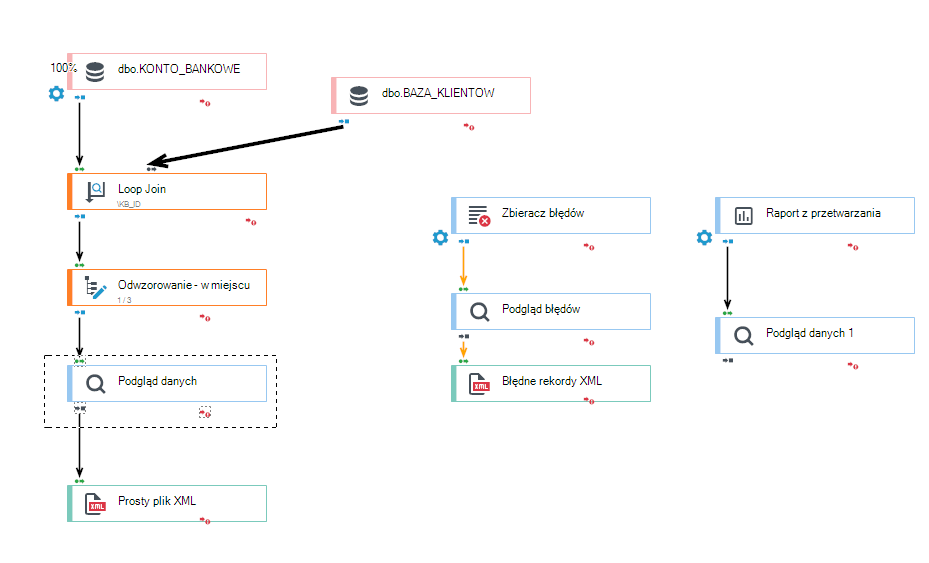
Za pomocą odpowiedniego bloczka wyjściowego wygenerowane dane z raportu zostaną zapisane w odpowiednim formacie we wskazanym przez Użytkownika miejscu bądź przedstawione w podglądzie danych.
Odbij zapytanie

Bloczek Odbij zapytanie odpowiada na zapytanie prostą funkcją jego treści. Nie odpytuje zewnętrznych źródeł danych.
Adnotacja tekstowa

Bloczek Adnotacja tekstowa umożliwia dodawanie opisów (komentarzy) w ramach tworzonego pakietu przetwarzania danych.