Bloczki plikowe- wspólnie mechanizmy
Koncepcja mulitiplików
Koncepcja multiplików pozwala traktować grupę fizycznych plików jako jeden ciągły logiczny plik.
- Sytuacja, która często występuje podczas Masowego Przetwarzania Danych plikowych jest wczytywanie i przetwarzanie zbioru plików o identycznej strukturze.
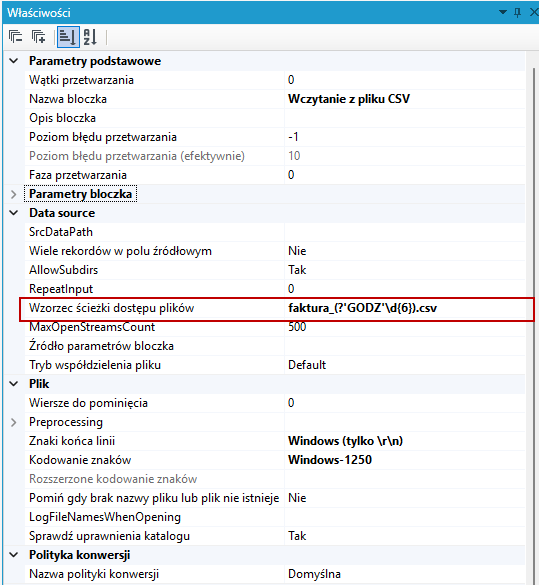
- Aby dało się łatwo operować na takich zbiorach, wszystkie bloczki reprezentujące pliki wejściowe mają atrybut Wzorzec ścieżki dostępu plików (FileListPattern), który można ustawiać w oknie Właściwości.
- Wartość, jaką należy ustawić w tym atrybucie to wzorzec nazwy dla wszystkich plików, które mają zostać przetworzone.
- Wzorzec ten ma postać wyrażenia regularnego, w którym grupy nazwane są, a następnie dodawane, jako pola do każdego rekordu wyprowadzanego z tego bloczka.
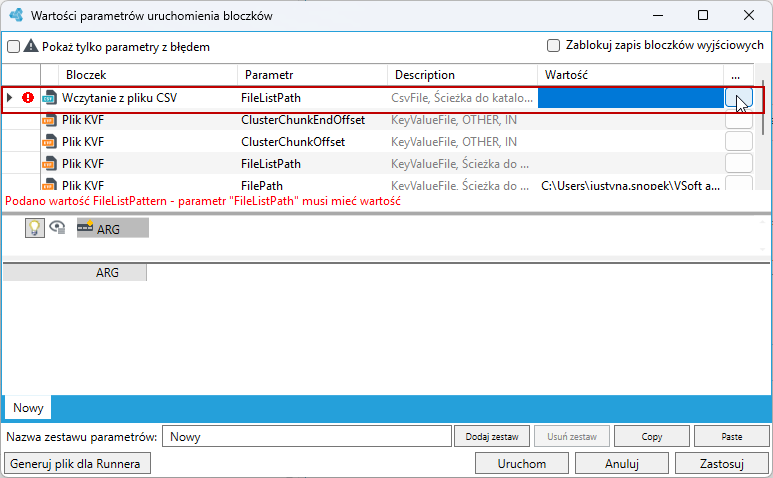
- W przypadku korzystania z listy plików, podczas uruchamiania pakietu, Użytkownik ustawia parametr FileListPath, a nie FilePath.
Przykładowo
Przygotowujesz pakiet, który będzie codziennie wieczorem wczytywał zbiór plików płaskich (CSV) wyprowadzanych przez system X do bazy danych. Wszystkie pliki wyprowadzane przez system X mają nazwę postaci:
faktury_<godzina>.csv
- Przykładowe nazwy plików:
faktury_120533.csv,faktury_083000.csv, itp. - Aby obsłużyć wczytywanie wszystkich plików jednym pakietem, Pan Jan, na przygotowanym wcześniej bloczku Plik wejściowy CSV ustawia właściwość Wzorzec ścieżki dostępu plików (FileListPattern) wartością
faktura_(?'GODZ'\d{6}).csv, co spowoduje, że wszystkie pliki, których nazwa zostanie dopasowana przez powyższe wyrażenie regularne będą przetwarzane.
Więcej informacji na temat wyrażeń regularnych - patrz: Wyrażenia regularne
- Dzięki użyciu grupy nazwanej
GODZmasz dostęp do informacji, z którego pliku rekord pochodzi – w schemacie rekordów wychodzących z bloczka CSV pojawi się pole o identycznej nazwie jak grupa ze znakiem podkreślenia_na początku.
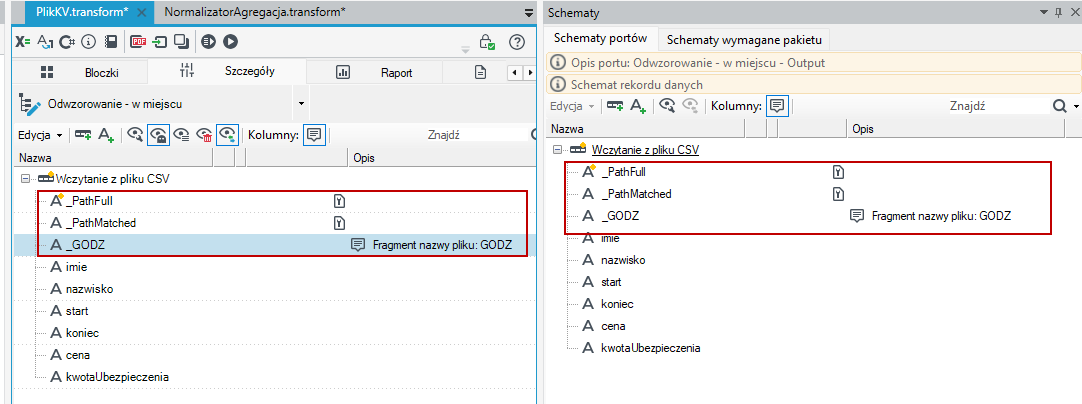
- Dla każdego rekordu, który będzie przetwarzany, w polu
_GODZpojawi się wartość jaka została dopasowana dla tej grupy dla nazwy pliku, z którego pochodzi rekord. - Jeśli rekord będzie wczytywany z pliku
faktura_130700.csvw polu_GODZpojawi się wartość „130700” a jeśli rekord będzie z plikufaktura_223500.csvto pole będzie miało wartość ”223500”. - Podczas uruchamiania pakietu musisz jeszcze ustawić opcję FileListPath.
- Bardzo podobna sytuacja, jak w przypadku Odczytu z listy plików, może pojawić się w zapisie do pliku. Nazwa pliku, do którego rekord ma zostać zapisany może zależeć od wartości pola/kilku pól w danym rekordzie.
- W takim przypadku w polu Wzorzec ścieżki dostępu plików należy podać nazwę pliku wyjściowego, a pola, które decydują o nazwie, znajdują się pomiędzy znakami
{‘‘}
Przykładowo:
Mając następujący schemat rekordów dla pliku wyjściowego:

- Umieszczając w polu Wzorzec ścieżki dostępu plików (FileListPattern) wartość
Result_{FiledType}_{Time}.posnazwa pliku będzie zależała od wartości pólFiledTypeiTime. - Jeśli zatem w wybranym rekordzie pole FiledType będzie miało wartość „KI”, a Time „23_33_07”, to nazwa pliku, do którego zostanie zapisany rekord będzie miała postać:
Result_KI_23_33_07.pos
Zachowanie w przypadku braku pliku lub ścieżki do pliku
Podczas przetwarzania może dojść do sytuacji, w której nie będzie podana ścieżka do pliku lub plik wskazywany przez tę ścieżkę nie będzie istniał.
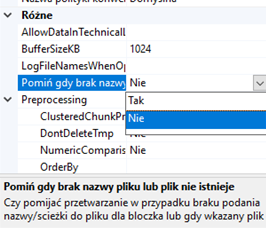
Zachowanie Systemu w takim przypadku zależy od wartości parametru Pomiń gdy brak nazwy pliku lub plik nie istnieje we właściwościach bloczka:
- gdy parametr ten ma wartość Nie (False), podczas próby uruchomienia pakietu wystąpi błąd i żadna część pakietu nie zostanie wykonana, przetwarzanie zostanie zakończone jako błędne,
- dla wartości Tak (True), w takiej sytuacji bloczek zachowa się tak, jakby nie było w pliku żadnych danych. Przetwarzanie będzie przebiegać normalnie.
Wczytywanie plików skompresowanych
- Bloczki: Plik wejściowy CSV, Plik analizowany wyrażeniami regularnymi, Plik stałopozycyjny, Plik wejściowy KVF, Plik wejściowy FWDK i Prosty plik XML, mają możliwość wczytywania danych bezpośrednio z plików skompresowanych w formacie zip lub gzip.
- To, czy plik jest skompresowany i w jakim formacie rozpoznawane jest po rozszerzeniu wczytywanego pliku:
.gzdla plików gzip i.zipdla plików zip. - Wielkość liter rozszerzenia nie ma znaczenia. W przypadku plików zip odczytywany jest tylko pierwszy plik z archiwum.
Pliki pośrednie
- Pliki pośrednie to pliki wygenerowane w jednej fazie przetwarzania pakietu i wczytywane w późniejszej.
- Pliki te są tworzone jak każdy inny plik i pozostają na dysku po zakończeniu wykonywania pakietu. Jednak nie będzie sprawdzane ich istnienie podczas uruchamiania pakietu.
- Pliki przejściowe można wczytywać za pomocą bloczków Prosty plik XML, Plik stałopozycyjny i Plik CSV. W właściwościach Źródło parametrów bloczka należy wskazać plikowy bloczek wyjściowy odpowiedniego typu z wcześniejszej fazy.
- Bloczki zapisujące pliki pośrednie nie wymagają żadnej dodatkowej konfiguracji.