Przetwarzanie danych
Podczas tworzenia pakietu wymagane jest odpowiednie dostosowywanie rekordów oraz pól schematów.
Możliwość taką daje menu kontekstowe zawierające listę opcji dostępnych dla wybranego obiektu, po jednokrotnym naciśnięciu prawego klawisza myszy.
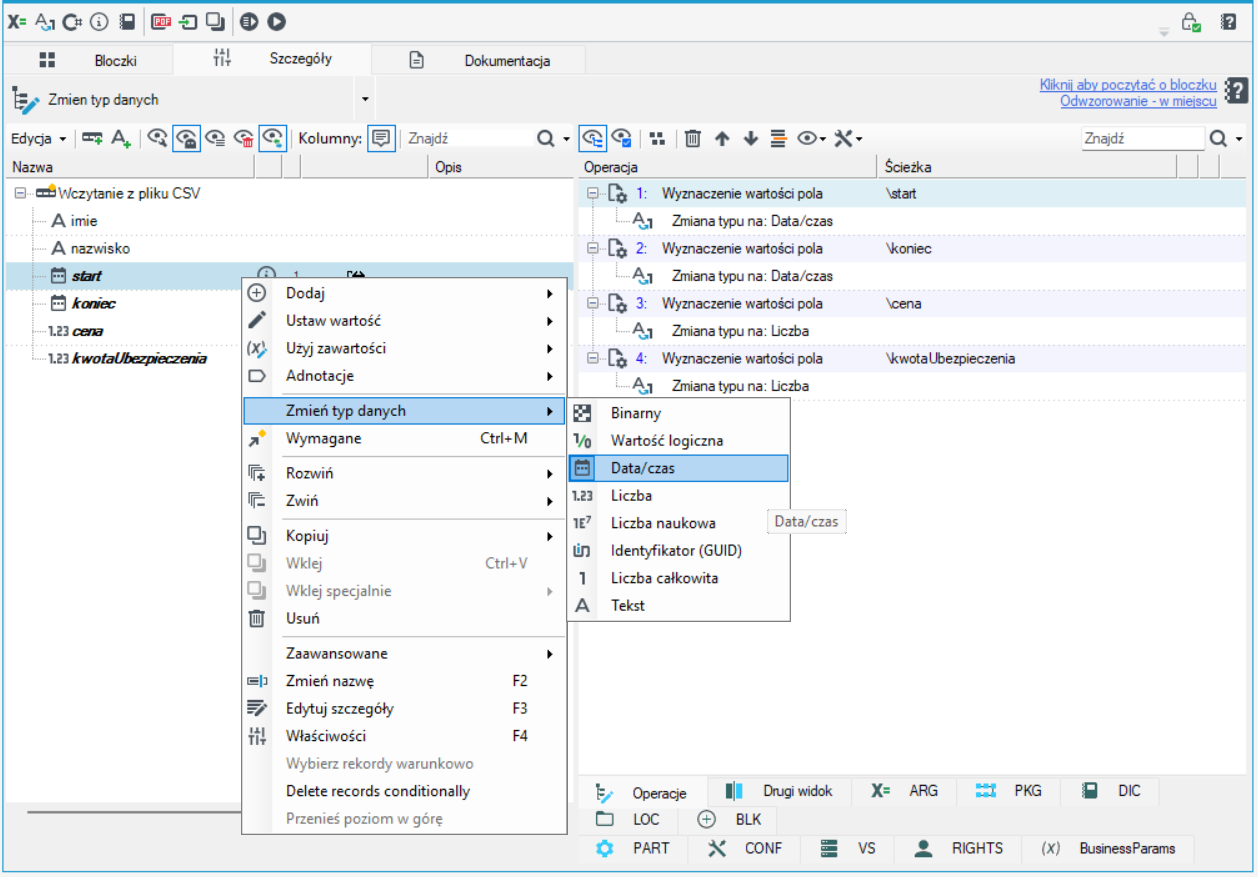
W zależności od rodzaju modyfikowanego elementu (rekord, pole) oraz wariantu zastosowanego bloczka udostępniane są różne opcje w menu kontekstowym.
Schemat danych, który prezentowany jest na zakładce Szczegóły na różnych bloczkach w pakietach przetwarzania danych jest analogiczny jak schemat danych prezentowany na formularzach w Mapowaniach startowych. Wykorzystywane są tutaj funkcjonalnościMapowań - czyli różnego rodzaju modyfikacji na danych, odwzorowań i operacji do wykonania, itp. Więcej patrz: Czym są Mapowania.
Przetwarzania danych platformy archITekt jest zorientowane na modyfikacje drzewiastych struktur danych.
Okno edycji drzewa jest dostępne w wielu miejscach pakietu, zwłaszcza w bloczkach zawierających odwzorowanie.
- Kontrolka pokazuje drzewo złożone z ikon i nazw elementów.
- Opcjonalnie, można przełączyć widoczność dodatkowych kolumn służących do prezentacji adnotacji (na pasku narzędzi drzewa menu Widok). Najważniejsze adnotacje powinny pokazywać się automatycznie – w przeciwnym wypadku, można przełączyć widoczność kolumn ręcznie.
- W niektórych kontekstach (np. w odwzorowaniu w miejscu) można zmieniać nazwy elementów drzewa. Wejście w edytor nazwy odbywa się standardowo: w chwilę po drugim kliknięciu w nazwę lub po naciśnięciu klawisza F2.
- W niektórych kontekstach elementy drzewa schematu można przesuwać za pomocą metody "Drag&Drop" – jest to podstawowa możliwość edycji drzewa. Po upuszczeniu elementu (elementów) mamy do dyspozycji kilka możliwości. Na drzewie można upuszczać elementy z tego samego drzewa (w tym z innego widoku – zakładka Drugi widok edytora odwzorowania), z innego drzewa (np. zakładki Schematy lub Bazy danych) a także z edytora tekstowego (tekst zostanie zinterpretowany jako lista nazw pól).
- Edycja typów danych oraz wymagalności jest możliwa – odbywa się z menu kontekstowego konkretnego węzła drzewa.
Edycja adnotacji jest możliwa na dwa sposoby, zależnie od adnotacji (od jej stopnia złożoności):
- Małe adnotacje: w kolumnie drzewa – wejście w edytor w chwilę po drugim kliknięciu,
- Duże adnotacje: w dolnym panelu Szczegóły– w zakładkach wyświetlane są wszystkie edytory dużych adnotacji „przyczepionych” do zaznaczonego węzła drzewa.
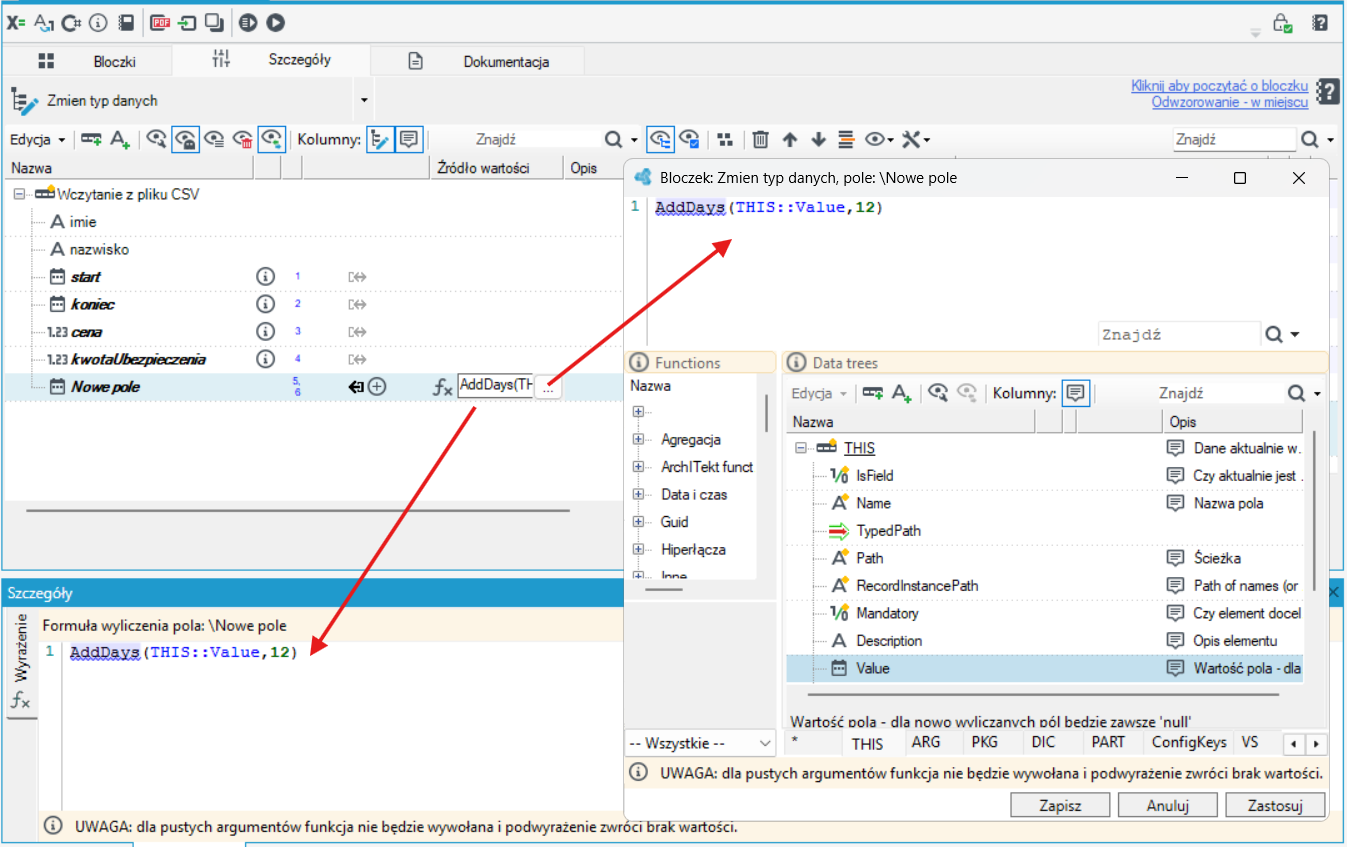
Tabela możliwości odwzorowań
Poniższa tabelka zbiera różne dostępne sposoby przekształcania danych – za pomocą różnych bloczków i różnych opcji bloczka Odwzorowanie w miejscu czy bloczków zawierających go w składzie.
| Rodzaj operacji | Sposób realizacji |
|---|---|
| Dodanie pola/rekordu do schematu. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe (lub pasek narzędzi drzewa)> Dodaj pole / rekord. Dla ułatwienia szybkiego dostępu menu Dodaj jest dostępne pod klawiszem Ins. |
| Usunięcie pola/rekordu. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe (lub pasek narzędzi drzewa) > Usuń, lub w drzewie klawisz Del. |
| Zmiana pola/rekordu z niewymaganego na wymagane. | Bloczek Odwzorowanie - w miejscu; Menu kontekstowe > Wymagalność 0/1.. W trakcie działania, rekordy nie spełniające wymagalności, zostaną odrzucone na wyjście błędów z błędem poziomu „2”. |
| Zmiana pola/rekordu z wymagalnego na niewymagalne. | j.w. W trakcie działania nie ma efektów dodatkowych. |
| Wyliczenie wartości pola: 'Stała'. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa > Adnotacje>Źródło wartości-stała. W kolumnie Źródło wartości można edytować wartość. |
| Wyliczenie wartości pola: 'Wyrażenie'. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa>Adnotacje>Wyrażenie. Skrót prowadzący od razu do wyliczania nowej wartości: Dodaj pole (wyrażenie). |
| Wyliczenie wartości pola: 'kopia z innego pola'. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa> Adnotacje>Kopia. Adnotacja Kopia jest też przypinana w wyniku operacji „Drag&Drop” zakończonej wyborem Kopiuj z adnotacją (a zmieniana przez Zmień adnotację). Podczas odwzorowania należy uważać na zwężanie (agregację) odwzorowania – czasem może być konieczne wyrażenie agregujące (np. min, max, count, avg). |
| Wyliczenie wartości: zmiana typu wartości. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa>Typ danych. Opcjonalnie, można doprecyzować konfigurację używanego parsera za pomocą adnotacji Parser. Bez tego, zostanie użyty domyślny parser z polityki (wybranej z nazwy na bloczku, lub domyślnej). W konfiguracji parsera określamy m.in. sposób postępowania z wartościami pustymi czy błędnymi. |
| Wyliczenie wartości: odwzorowanie przez słownik. | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa>Adnotacje> Słownik. W opcjach adnotacji słownikowej określamy nazwę słownika, kolumny klucza i wartości, sposób postępowania w przypadku pustych wartości lub braku klucza. |
| Przesunięcie pola / rekordu w inne miejsce (w tym z klonowaniem rekordu w wiele miejsc docelowych, jeśli po drodze jest rekord „wielokrotny”). | Bloczek Odwzorowanie - w miejscu; drag&drop w nowe miejsce. Późniejsza ew. zmiana nazwy skutkuje aktualizacją operacji Klonuj. |
| Wybór szczególnych rekordów z rekordu wielokrotnego – klasyfikacja rekordów wewnątrz rekordu-rodzica. Np. aby zapisać poszczególne rekordy do różnych tabel bazy, czy umieścić w innych elementach XML wynikowego. | j.w. (sic!) W opcjach powstałej operacji Klonowanie rekordu można wpisać: warunek wyboru rekordu, flagę, czy wybrane rekordy klonować, czy przenosić, flagę, czy wybrać tylko pierwszy z rekordów spełniających warunek. |
| Ułożenie rekordów wielokrotne w żądanej kolejności (w ramach rekordu-rodzica). | Bloczek Odwzorowanie - w miejscu; menu kontekstowe drzewa>Adnotacje> Sortuj. Parametry adnotacji umożliwiają określenie kluczy sortowania. |
| Połączenie kilku sąsiednich rekordów w jeden wspólny korzeń na podstawie klucza/kluczy – tzw. NORMALIZACJA. Potrzebne np. po odczycie danych z operacji SQL JOIN czy płaskich, zdenormalizowanych (nadmiarowych) plików. | Bloczek Normalizator. Trzeba dodać adnotację Przepis normalizacji rekordu do rekordu, który podlega normalizacji. Określamy klucz (pola, których równe wartości w kolejnych rekordach spowodują ich scalenie), pola i rekordy dołączone (wartości sąsiadów nie są porównywane, ale także złączane). Klucz można też określić za pomocą odrębnej adnotacji Klucz normalizacji. |
| Podzielenie rekordu na mniejsze, oddzielne. | Bloczek Separator rekordów– wskazujemy do dwóch punktów odcięcia rekordów-dzieci (lub klonowania). |
| Przetwarzanie rekordu na całkowicie różne sposoby – podzielenie oddzielnych rekordów na „kupki”. | Bloczek Klasyfikacja – dla każdego wyjścia określamy wyrażenia zwracające wartość logiczną (prawda/fałsz). Zwrócenie „prawdy” powoduje wyjście rekordu danym wyjściem. Brak wyrażenia jest traktowany jako „prawda”. Są dwa sposoby pracy klasyfikatora. |
| Połączenie różnych ścieżek przetwarzania podobnych rekordów. | Bloczek Łączenie ścieżek. |
| Obrócenie schematu rekordów – zmiana rekordu wielokrotnego, opisującego listę „nazwa:wartość” w płaski rekord z wartościami w oddzielnych polach. Tzw. Pivot. | Bloczek Wiersze na kolumny. |
| Przygotowanie nowego, znacznie mniejszego rekordu niż wejściowy, opierając się na rekordzie wejściowym. Przydatne np. do wytwarzania niewielkich zapytań do bazy. | Bloczek Odwzorowanie-kopia.. Bardzo rzadko przydatny w oderwaniu od zapytań. |
| Dołączenie do rekordu innych potrzebnych rekordów, z innych źródeł. | Bloczki Loop Join lub Łączenie posortowanych rekordów – w zależności od tego czy dołączamy na podstawie wyników oddzielnych zapytań, czy scalamy posortowane strumienie. Drugi sposób jest oczywiście polecany, jeśli tylko możliwy w danym kontekście, z uwagi na możliwość znacznej optymalizacji przetwarzania. |