Słownik jako pamięć podręczna
Często podczas opracowywania dużych zbiorów danych, ze względów wydajnościowych bardzo przydaje się funkcja zapamiętywania elementów w pamięci serwera (elementy te są też zwykle zapisywane w bazie danych). Rozwiązanie takie prowadzi do wielokrotnego przyspieszenia działania pakietu przetwarzania, jednak wymaga rozważenia i prawidłowego zastosowania kilku elementów.
- Wykorzystujemy tu fakt, że słownik w Przetwarzaniu danych jest dowolną tabelą, niekoniecznie bazodanową (o kolumnach typu napisowego), która może być zarówno modyfikowana, jak i odczytywana w trakcie działania pakietu. Jeśli zadbamy o umieszczenie weryfikacji treści słownika i jego uzupełnianie w jednym wątku przetwarzania w fazie, otrzymamy skuteczny mechanizm pamięci podręcznej.
Ilustruje to poniższy przykład:
- Załóżmy, że chcemy odróżnić elementy już przetworzone (np. zapisane do bazy danych) od nieprzetworzonych. Jest nam to potrzebne do skierowania elementów - duplikatów na inną ścieżkę (np. tylko do raportu) o wyższej wydajności przetwarzania (np. bez zapisu do bazy).
- Minimalistyczny pakiet realizujący to zadanie może wyglądać tak, jak na rysunku poniżej.
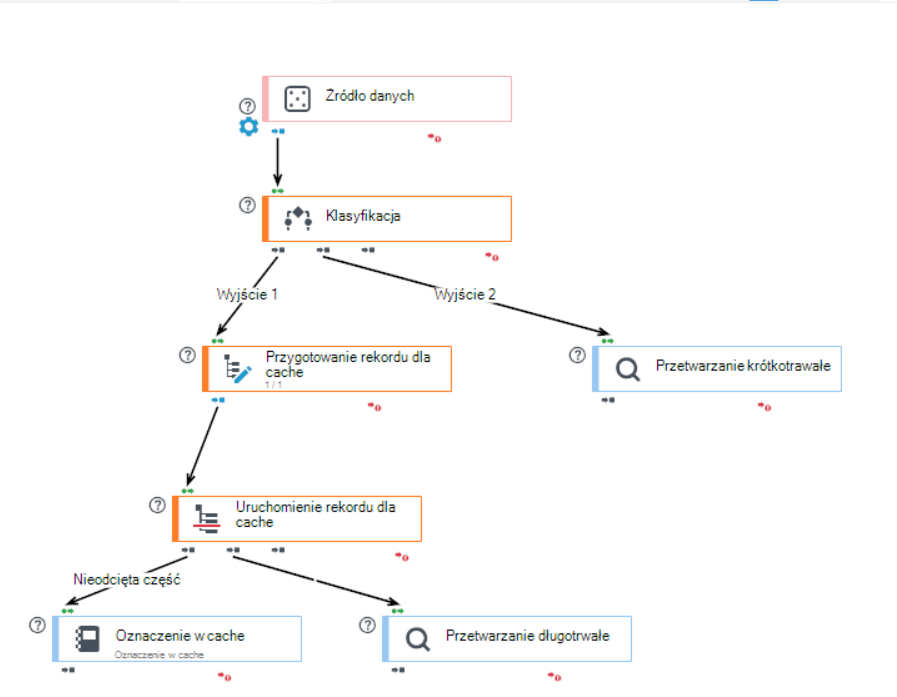
- Bloczek Oznaczenie w cache deklaruje słownik o nazwie np. "cache1" i kluczu o raz wartości „klucz”. Tak też się nazywa jedyne pole generowane przez Źródło Danych, które jest kopiowane do nowego rekordu i obcinane w parze bloczków Przygotowanie rekordu dla cache i Uruchomienie rekordu dla cache.
Wyrażenie klasyfikacji wygląda następująco:
dic.cache1__klucz( ToString(klucz)) is_empty
Generujemy tu klucze całkowite z zakresu np. 0-1000 w ilości 10`000 elementów. Średnio 10x więcej rekordów powinno zostać skierowanych na ścieżkę „Ścieżka szybka – Oznaczenie w cache” niż do przetwarzanie długotrwałe.
Ważne, aby podgraf spójny synchronicznie deklarował tu tylko 1 wątek przetwarzania, w przeciwnym razie w strumieniu „powolnym” mogą pojawić się duplikaty kluczy.