Operacja zapytania do MongoDB
Operacja zapytań do MongoDB działa podobnie jak operacja zapytania w SQL lub wywołanie algorytmu. Pozwala nam na wczytanie pewnych dokumentów i dołączenie ich do aktualnego miejsca w naszym drzewie danych.
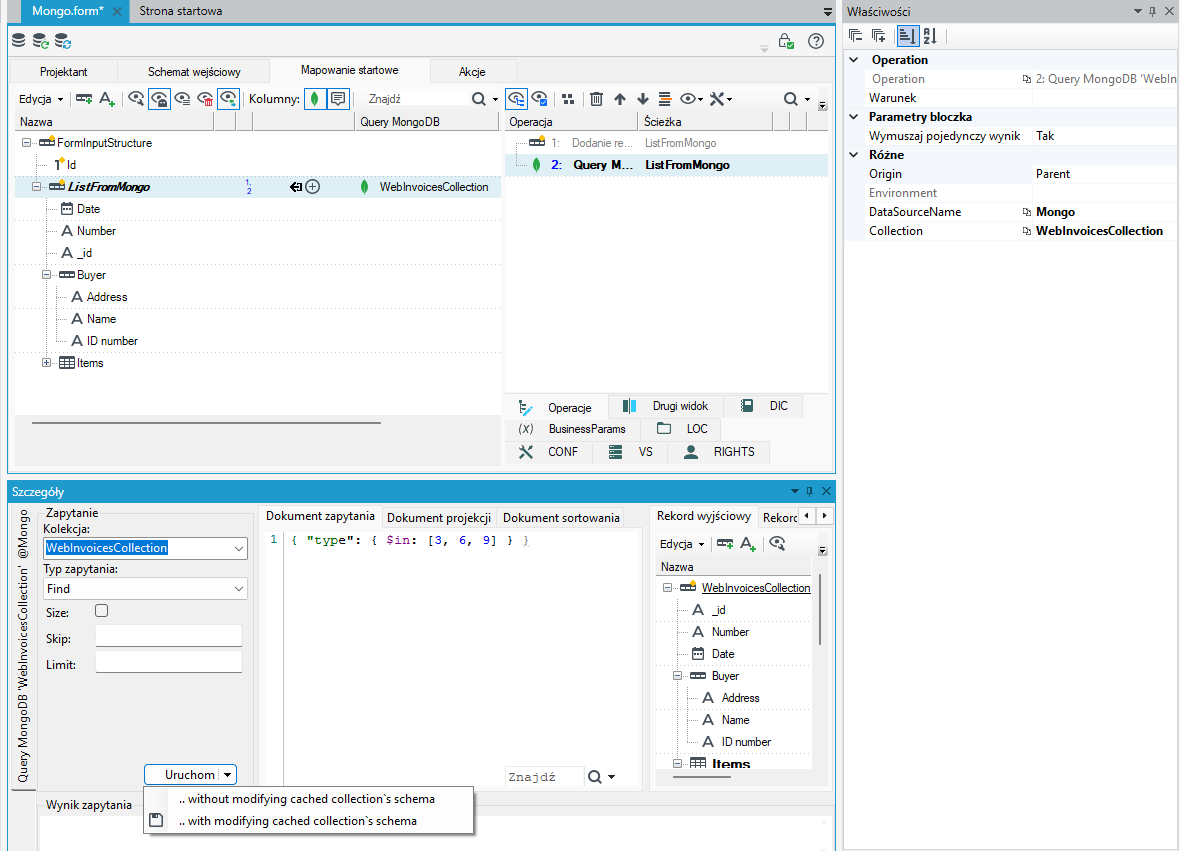
Główna różnica polega na strukturze naszego wyniku:
- Nie jest to już "płaska" tabela, ale drzewo - MongoDB jest bazą dokumentową, a nie relacyjną.
- Struktura jest zamrożona w czasie projektowania (zakładka Rekord wyjściowy na rysunku powyżej). Każda kolekcja MongoDB może zawierać dowolne dane o dowolnej strukturze. Nie ma żadnej gwarancji, że pobrane dokumenty będą zgodne z jakimkolwiek schematem znanym w czasie projektowania.
Tak fundamentalna decyzja projektowa MongoDB wymaga obejścia w środowisku statycznie typowanym, takim jak nasze. Działa ono na prostej zasadzie - w czasie projektowania wszystkie przewidywane elementy i pola dokumentów muszą interferować do przykładowych dokumentów już obecnych w kolekcji, albo zostać dodane (lub zaimportowane) ręcznie w edytorze. Wszystkie dodatkowe elementy i pola rzeczywiście obecne w dokumentach później, w run-time, zostaną odrzucone. Wszystkie brakujące elementy i pola będą, brakujące, z wartością pustą.
Inną smutną konsekwencją braku dobrego mechanizmu opisu schematu jest brak osadzonej dokumentacji - mówiąc inaczej, nie ma opisów w drzewie. Z pewnością ta wada zostanie jakoś naprawiona przez twórców MongoDB w najbliższej przyszłości, ale póki co jedynym sposobem na udokumentowanie zawartości kolekcji jest zrobienie tego ręcznie w panelu Bazy danych.
Poza faktem, że operacja zapytania Mongo DB jest operacją mapowania i może działać in-line w mapowaniu, dołączonym do dowolnego, dowolnie zagnieżdżonego rekordu, działa ona dość podobnie jak blok zapytania w MongoDB. Musimy wybrać kolekcję i określić przewidywany wynik w postaci zapytania, zamówić i posortować dokumenty w formacie podobnym do JSON czyli BSON. Niektóre najpopularniejsze operatory MongoDB i fragmenty zapytań są dostępne w funkcji autouzupełniania (Ctrl+Spacja).
Proste zapytanie filtrujące po wbudowanym polu _id i odwołujące się do naszych danych może wyglądać tak:
{ "_id" : #(myRequestedDocumentId)# }
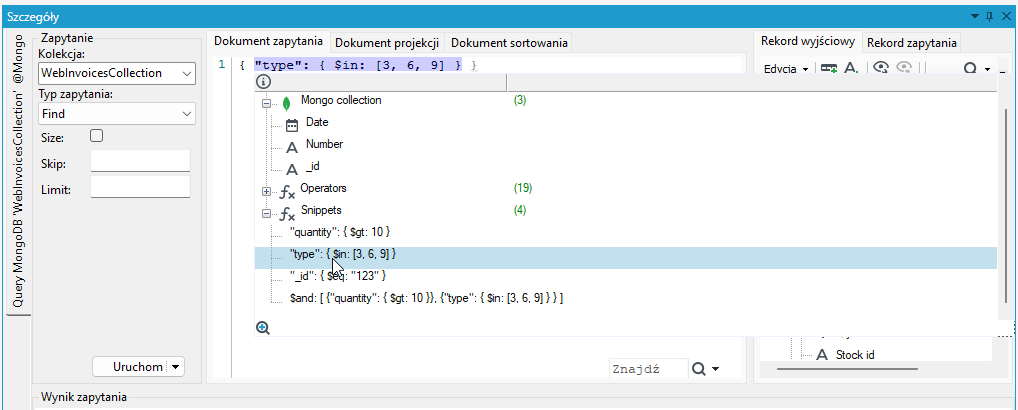
Operację możemy stworzyć w następujący sposób:
- Wybierz z menu kontekstowego opcję Wypełnij rekord>Query MongoDB, a następnie wybierz kolekcję źródłową (i być może nazwę źródła danych) w panelu Szczegóły operacji.
- Przeciągnij kolekcję mongo z panelu Bazy danych na rekord (co automatycznie ustawi źródło danych i kolekcję).
Następnie powinniśmy wpisać (korzystając z autouzupełniania Ctrl+spacja) przynajmniej dokument specyfikacji zapytania (chyba, że chcemy aby wszystkie dokumenty zostały wczytane) i uruchomić nasze zapytanie. Spowoduje to zastąpienie/uzupełnienie naszego schematu wyjściowego tego zapytania. Nasza operacja wyprodukuje tylko pola/elementy "poznane" na tym etapie.
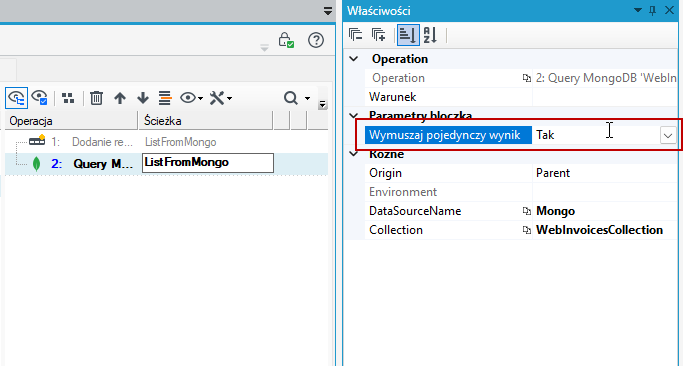
Operacja posiada opcję Wymuszaj pojedynczy wynik, podobnie jak w operacji zapytania SQL, aby zwrócić tylko pierwszy dokument spełniający nasze kryteria. Nie ma innego sposobu na poinformowanie systemu, że nasz wynik musi być unikalny. Bez tego, rekord wynikowy będzie miał postać listy, co może prowadzić do późniejszych komplikacji. Chociaż w niektórych scenariuszach lista jest dokładnie tym, czego potrzebujemy.
Schematy kolekcji
Istnieje znaczna różnica w tym, jak bazy danych podchodzą do problemu "schematu". Większość relacyjnych baz danych zawiera tabele o sztywnej, dobrze znanej strukturze (lista statycznie typowanych kolumn) i wszystkie wiersze danych muszą się do niej stosować. Z drugiej strony większość nierelacyjnych baz danych widzi to zupełnie odwrotnie - elementy danych (dokumenty, wpisy) zwykle muszą mieć tylko jakiś "identyfikator" ID, reszta może być zupełnie dowolna. W praktyce wszystkie dokumenty leżące w tej samej kolekcji, są podobne, jeśli nie identyczne. W takim środowisku nie ma naprawdę dobrego sposobu na określenie, jakich atrybutów danych możemy użyć, z wyjątkiem korzystania z jakiejś formy dokumentacji dla naszych zbiorów (nie ma tu żadnego standardu...) lub badania każdej istniejącej (lub planowanej) instancji dokumentu.
Nasza platforma używa tutaj mieszanki dwóch podejść.
- Aby wyświetlić cokolwiek wartościowego w panelu Bazy danych (czyli kolekcje z jakąś możliwą do wykorzystania strukturą) wczytujemy kilkaset instancji dokumentów i wpływamy na strukturę poprzez łączenie wszystkich wykrytych struktur częściowych.
- Kolekcje można również edytować ręcznie. Wszystkie nowe pola/rekordy są tymczasowo oznaczane jako nowe znakiem +.
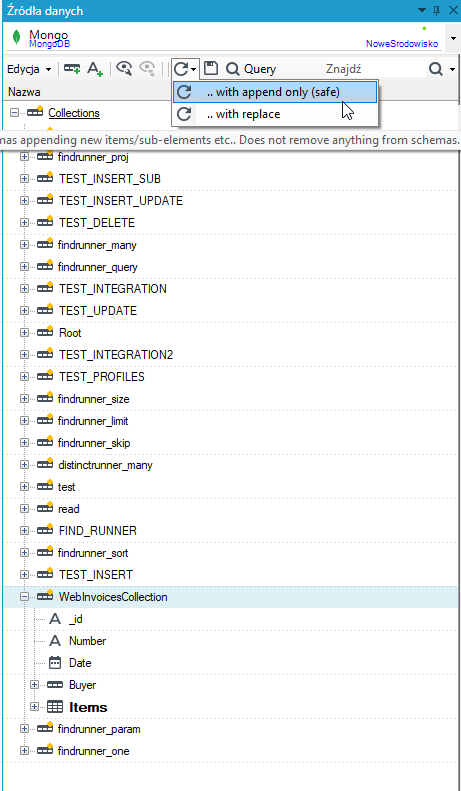
- Przycisk pobierania struktury na panelu Bazy danych domyślnie działa w sposób "bezpieczny", czyli nie usuwa nic z naszego schematu with append only (safe). Istnieje również opcja pełnego zastąpienia naszego cache'u świeżo pozyskanymi strukturami z podłączonej instancji MongoDB (tak jak w relacyjnych bazach danych) - Opcja with replace.
- Każda kontrolka zapytań do MongoDB ma możliwość rozszerzenia naszej kolekcji schematu o nowo wykryte pola i rekordy - przycisk Uruchom ma do tego dwie opcje:
- without modifying cached collection's schema - tryb do przeglądania lokalnie w kontrolce
- with modifying cached collection's schema - tryb do przeglądania z uwzględnieniem co posiadamy w lokalnym cache kolekcji, wynik zapytania zostanie dołożony do tego co posiadamy w cache kolekcji.
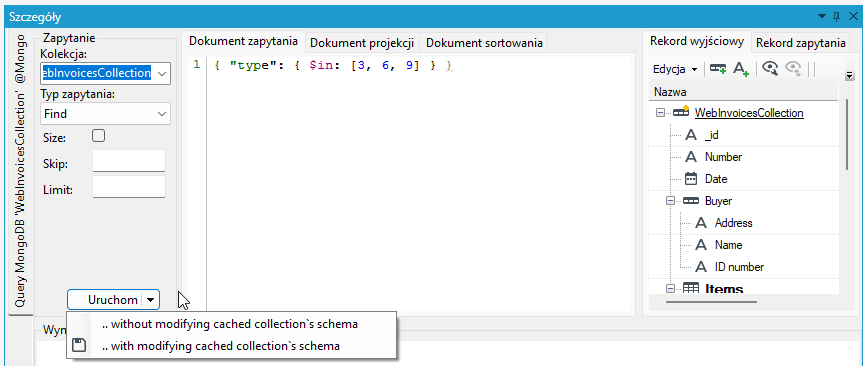
Możemy mieć tutaj różne praktyczne scenariusze:
- Łączymy się z już istniejącą bazą danych pełną dokumentów przylegających do jakiegoś schematu, inferencje struktury działają prawidłowo i cache/wyświetlają niektóre użyteczne schematy w panelu bazy danych.
- W naszych kolekcjach brakuje pewnych nowo dodanych pól/rekordów i musimy albo dodać je ręcznie, albo podać pewne dodatkowe kryteria (może wysokie ID, może nowsze daty), w niektórych dokumentach zapytania w edytorze, a następnie rozszerzyć nasz cache w oparciu o nowo pobrane dokumenty.
- Tworzymy kolekcje zupełnie od nowa. W tej technologii nie ma pojęcia "stwórz tabelę ...", więc zwykłe zapisanie struktury drzewiastej do świeżo nazwanej kolekcji wystarczy, mimo początkowego ostrzeżenia. Alternatywnie, możemy zaimportować/wpisać nową kolekcję w panelu Bazy danych i zacząć jej normalnie używać. Zapytania z tej kolekcji nie będą zwracały żadnych rzeczywistych danych (dopóki czegoś nie wstawimy). Nie ma obaw, w takim przypadku wynik zapytania zostanie skopiowany z naszego lokalnego cache.