Nie tylko ETL
Przetwarzanie danych, stanowi część platformy archITekt Studio, które powstało w wyniku uzupełnienia wielu braków typowych pakietów klasy ETL (ang. Extract, Transform, Load), a także dodania kilku unikalnych elementów, które ułatwiają lub de facto umożliwiają realizację szerokiej klasy zadań, do tej pory zarezerwowanych dla kodu - niedostępnego, niezrozumiałego i niemodyfikowalnego wprost przez analityków biznesowych.
Dlatego można powiedzieć, że Przetwarzanie danych wykracza poza definicję narzędzia klasy ETL poprzez:
- Przejrzystość zdefiniowanych procesów – co wyraża się w:
- użytej strukturze danych: dowolnego drzewa z relacjami,
- możliwości dopisania/generowania/pobrania dokumentacji w niemal każdym elemencie,
- funkcji przejrzystej tzw. „autodokumentacji” logiki przetwarzania,
- możliwości przeszukiwania definicji pod kątem np. operacji przetwarzania, obiektów bazodanowych,
- Możliwość dowolnego rozłożenia obciążenia i kształtowania wydajności:
- naturalne podejście do współbieżnych zadań modułu sterowania – rozwidlenia i złączenia w sieci zależności,
- możliwość łączenia bloczków przetwarzania za pomocą łączy synchronicznych lub kolejek,
- przydziału wątków roboczych do fragmentów grafów przetwarzania,
- szczegółowych raportów z wydajności poszczególnych elementów, statystyk bazy danych itp.,
- Liczne udogodnienia dla projektanta:
- podpowiadanie składni oraz semantyki wyrażeń „danych”, skryptów SQL, wyrażeń regularnych,
- sprawne przeszukiwanie drzewiastych struktur danych – po nazwach i komentarzach,
- opracowanie statystyczne tempa działania elementów, wydajności operacji bazodanowych, treści podobnych błędów i komunikatów odrzucanych rekordów,
- liczne dostępne operacje drag-drop wewnątrz edytorów schematów, a także z zewnętrznych struktur danych czy tekstu (np. z notatnika, excela),
- ewidencjonowanie zmian definicji w centralnym repozytorium (w Serwerze wersji) wraz z kontrolowaniem wielodostępu,
- Mniej typowe, ale bardzo przydatne funkcjonalności:
- wczytywanie danych z niemal dowolnych plików tekstowych wg specyfikacji w postaci drzew zbudowanych z wyrażeń regularnych,
- wznawianie przerwanej hierarchii zadań od momentu przerwania, z możliwością zmiany definicji czy zależności w trakcie działania,
- analiza graficzna zależności logicznych w nieznanych („cudzych”) skryptach SQL,
- zautomatyzowane profilowanie nieznanych zestawów danych (baz, zestawów plików),
- generowanie wartości losowych na podstawie wyrażeń regularnych,
- Konfigurowalność, w tym:
- dostosowanie a nawet wymiany dowolnego elementu platformy na potrzeby konkretnego wdrożenia,
- osadzenie dużych fragmentów przetwarzania w innym narzędziu (host) wraz z rozbudową/ograniczeniem dostępnych funkcji.
Wątki – Przetwarzanie danych
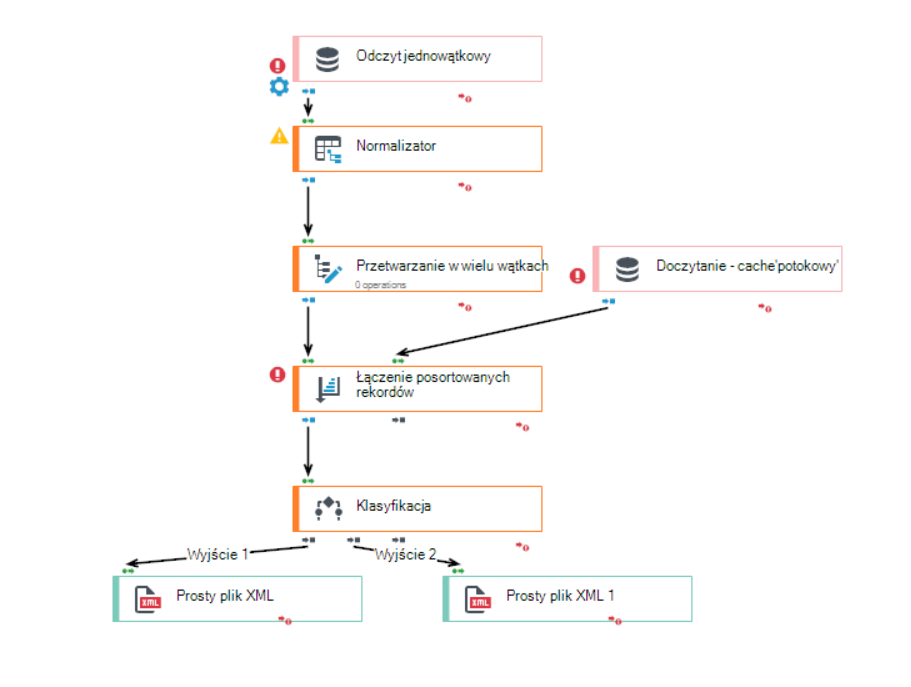
- Za pomocą pakietu pobierane są dane z jednego lub wielu źródeł.
- Każdy z rekordów jest odpowiednio przekształcany, łączony, dzielony lub/i odcinany, aby w końcu trafić do jednego z miejsc docelowych.
- Przekształcenia wykonywane są przez dowolnie określoną liczbę wątków. Należy w tym miejscu zwrócić uwagę na wydajność.
Drzewiaste struktury
Główną zaletą, która wyróżnia funkcjonalność przetwarzania danych, jest operowanie na drzewach danych (a nie strukturach płaskich).
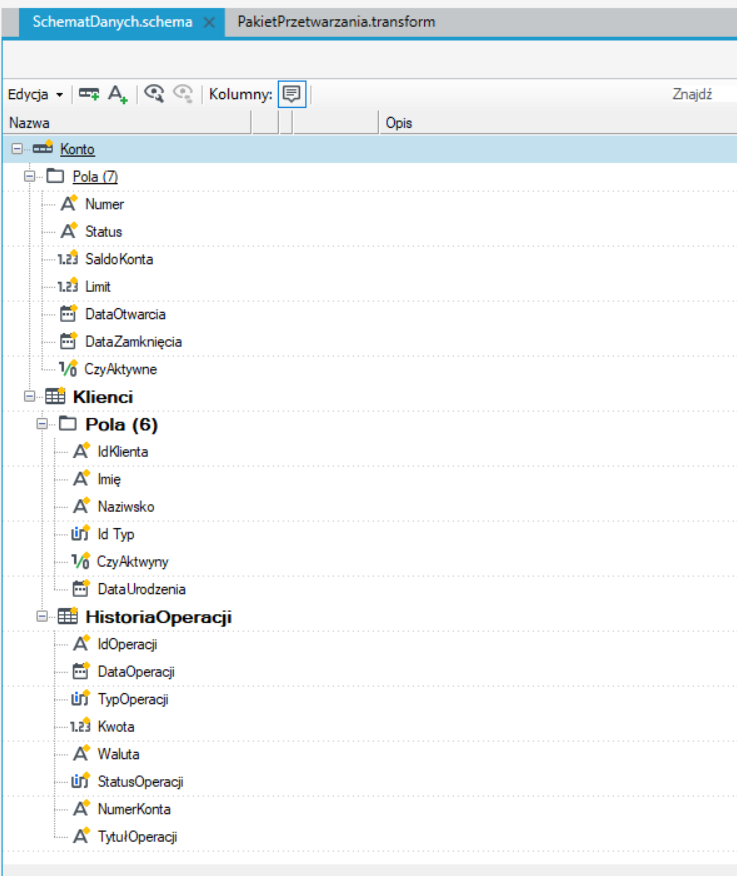
- Podstawową zaletą struktur drzewiastych jest niezwykła łatwość operowania poszczególnymi rekordami danych przy widocznym podziale na elementy nadrzędne oraz podrzędne.
- Węzłem drzewa jest rekord logiczny, składający się z pól oraz rekordów podrzędnych, które mogą być listami i reprezentować relację 1-wiele.
- Zastosowanie takiej struktury umożliwia niezależne przetwarzanie drzew rekordów logicznych bez konieczności ich rozbijania i utraty powiązań do „rodziców”.
- Powoduje też całkowicie naturalną integrację z „drzewiastymi” formatami danych (np. XML).
Więcej o schemacie danych patrz: Schemat Danych w Mapowaniach.