Zadania
W serwerze wersji w katalogu Hierarchy dostępny jest plik Main.batch, w którym to można definiować zadania. Zazwyczaj w systemie jest tylko jeden tego typu plik.
Podstawową jednostką pracy Hierarchii Zadań jest „zadanie”. Jest to element całej hierarchii zawierający następujące informacje:
- nazwa zadania,
- typ zadania (AssemblyName + TypeName),
- nazwy zadań – następników,
- parametry – dowolne pary napisów klucz-wartość z opcjonalną.
<task>
<name>C</name>
<type>archITekt.Runner_Test.Tasks.TestTask;archITekt.Runner_Test.dll</type>
<params>
  key="DbName" value="TEST_DB" />
</params>
<nextTasks>
 <nextTask>D</nextTask>
</nextTasks>
</task>
W bazie śledzenia zadań znajduje się tabela, która zwykle nazywa się dbo.TASKS.
W tabeli zapisywane są dodatkowe elementy dotyczące zadania, np.:
- ID zadania,
- ID cyklu i ID powtórki,
- Obecny stan zadania (patrz graf stanów),
- Postęp (określony w promilach: 0-1000),
- Ostatnie komunikaty z pracy zadania, np. dotyczące przyczyny nie uruchomienia się lub przerwania działania,
- Pozostały zserializowany stan w postaci XML,
- Nazwa komponentu wykonawczego (do scenariuszy klastrowych).
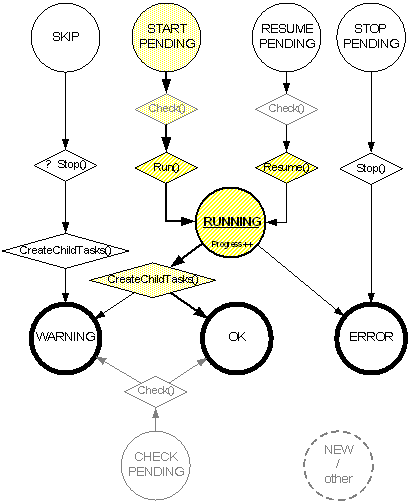
Przejścia zaznaczone na diagramie stanów wykonywane są automatycznie przez komponent TaskManager. Z kolei pozostałe przejścia, głównie NEW ? START_PENDING wykonywane są poprzez zewnętrzne mechanizmy, np. aplikację WWW lub trigger UH (Uniwersalnego Hosta).
Koła oznaczają stany zadania, w tym stany końcowe (gruba linia). Romby oznaczają funkcje wykonywane przez zadania:
- Check() – sprawdzenie warunków startowych zadania – można wykonywać bezpiecznie, bez wprowadzania zmian w otoczeniu (dlatego oznaczono na szaro),
- Run() – właściwe wykonanie pracy przez zadanie – zwykle czynność długotrwała powodująca aktualizację postępu (Progress++),
- Resume() – wznowienie pracy działania po wykryciu przerwania, często prowadzi do identycznego zachowania jak Run(),
- Stop() – zakończenie pracy zadania – po przejściu ze stanu SKIP bez uruchomionego zadania nie jest oczywiście wykonywane,
Podstawową ścieżkę przetwarzania zaznaczono na żółto.
ID cyklu („wsadu”) to numer cyklu przetwarzania (np. dziennego, miesięcznego), który nadawany jest przez mechanizm wpisujący zadanie do bazy. Kolejne ID powtórki (od 1) używane jest w celu zanotowania historii ewentualnych problemów z działaniem zadania (np. przez mechanizm automatycznego wznawiania).
Centralnym obiektem zarządzającym i kontrolującym przebieg procesu jest TaskManager. TaskManager zajmuje się pobieraniem nowych zadań do realizacji, zatrzymywaniem zadań na żądanie oraz finalizacją i tworzeniem zadań potomnych według określonej hierarchii. Dodatkowo, TaskManager wpółpracuje z odpowiednim dostawcą zadań – providerem (obecnie tylko bazodanowy) oraz posiada możliwość podłączenia obiektu hierarchii, która ustala następców i poprzedników każdego zadania (obecnie służy do tych celów plik XML o określonej strukturze).
Zadanie trafia do managera zadań na jeden z kilku sposobów – poprzez wpisanie (zwykle w stanie START_PENDING) do tabeli TASKS:
- uniwersalnego hostu, który uruchamia zadanie wg własnych definicji „triggerów”,
- nazwy zadania jako głównego argumentu wywołania programu
archITekt.Runner.exe, - części kodu np. w aplikacji WWW.
Od tej pory zadanie zaczyna być pod kontrolą Managera Zadań. W wyniku poprawnego zakończenia mogą zostać uruchomione zadania potomne (wpisane jako START_PENDING). Manager zadań przed ich fizycznym uruchomieniem sprawdza, czy zadania-poprzedniki są ukończone (w ramach bieżącego ID cyklu, maksymalna wartość ID powtórki). Jeśli nie, zadania będą oczekiwać na uruchomienie.
Działający Manager Zadań periodycznie notuje postęp zadań działających i przejścia stanowe w rekordach tabeli TASKS oraz w głównym logu (zwykle skierowanym do pliku tekstowego). Analiza zrzutu z tabeli TASKS lub ów log tekstowy jest podstawą to stwierdzenia przyczyny ewentualnego problemu w działaniu Systemu.
Parametry zadań
Każda definicja zadania składa się z definicji wartości parametrów, postaci klucz-wartość. Wartości zawsze są typu napisowego.
Wartości większości parametrów są potrzebne do prawidłowego zachowania się zadania – określają np.:
- wzorzec ścieżki pliku do załadowania,
- separator kolumn pliku,
- nazwę bazy danych, na której należy wykonać operacje,
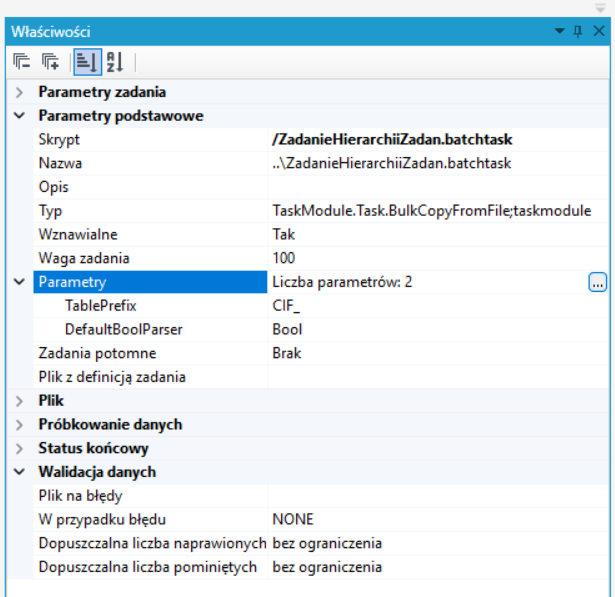
Parametry takie muszą posiadać nazwy rozpoznawalne przez zadanie. Wszystkie rozpoznawalne parametry mają odrębną reprezentację w panelu właściwości zadania – np. „TablePrefix”, tu o wartości „CIF_”.
Rozwiązywanie wartości parametrów
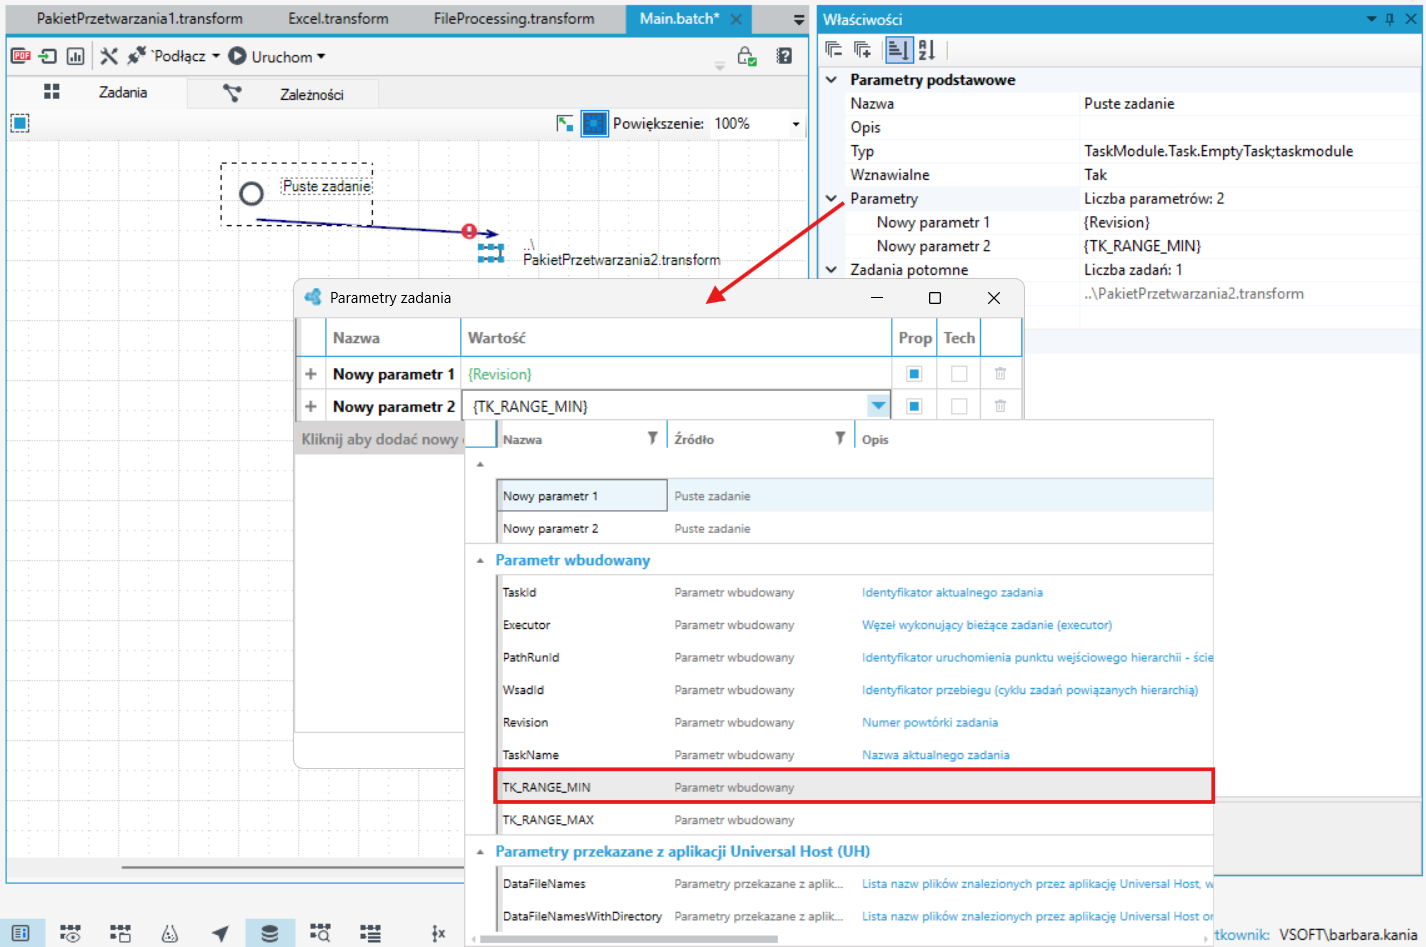
- Aby wprowadzić parametry dla zadania przejdź na panel Właściwości i kliknij przycisk w sekcji Parametry.
- W otwartym oknie Parametry zadania możesz definiować parametry.
W wartościach parametrów można stosować dwie specjalne konstrukcje, które będą rozwiązane do konkretnej wartości na etapie wykonania:
{Param}Ścieżka.txt;KATALOG
Pierwsza z nich jest zastępowana tekstowo wartością:
- dowolnego innego parametru (o nazwie „Param”), w tym propagowanego z zadań poprzedzających,
- elementu globalnego o takiej nazwie (patrz niżej),
- elementu konfiguracji o takiej nazwie.
Druga możliwość dotyczy parametrów, których wartość będzie interpretowana jako ścieżka. Zakładając, że logiczna nazwa katalogu „KATALOG” jest akurat skonfigurowana na wartość c:\katalog wartość parametru z przykładu zostanie rozwinięta do pełnej formy: c:\katalog\Ścieżka.txt
Elementy konfiguracji pochodzą zwykle z sekcji appSettings mechanizmów konfiguracji aplikacji .NET (plik App.exe.config lub pliki stamtąd importowane).
Dla przykładu:
Można łączyć obydwa sposoby konfiguracji – patrz parametr DataFile w przykładzie:
DataFile = {D2}\IBS_CIF_{D1}_{D2}.dat;DATA
Jest to odwołanie do pliku w katalogu o logicznej nazwie „DATA”, podkatalogu nazwanym parametrem odziedziczonym o nazwie „D2”, gdzie w nazwie wystąpią wartości parametrów „D1” oraz „D2”.
Parametry globalne
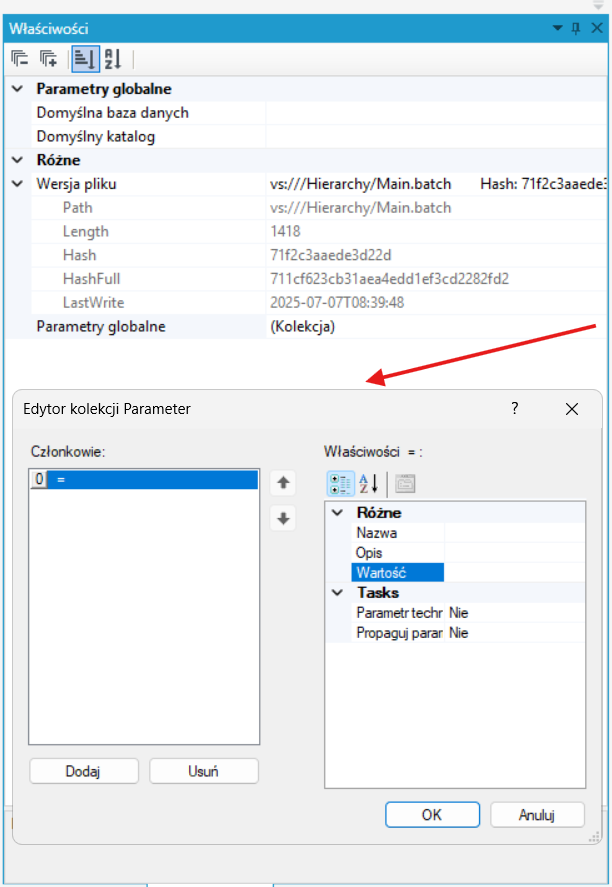
W definicji Hierarchii Zadań można określić parametry globalne, przypisane nie do zadania ale do całej definicji hierarchii. Z wartości tych parametrów można korzystać w definicjach parametrów (jak opisano wyżej) czy w samych zadaniach (np. domyślne nazwy baz danych). Definicji dokonuje się we właściwościach Hierarchii Zadań (jest dostępna w panelu Właściwości po zaznaczeniu pustego obszaru edytora zadań).
Parametry wbudowane
TaskId- identyfikator aktualnego zadania,Executor- węzęł wykonujący bieżące zadanie (executor),PathRunId- identyfikator uruchomienia punktu wejściowego hierarchii - ścieźki,WsadId- identyfikator przebiegu (cyklu zadań powiązanych hierarchią ),Revision- numer powtórki zadania,TaskName- nazwa zadania.
Dowolne parametry
- Za pomocą elementu „Tablica Parameter[]” można określać dodatkowe parametry, nawet nierozpoznawane przez zadanie. Mogą one posiadać dodatkową cechę – propagowalność. Oznacza to, że parametr taki wraz z wartością będzie przekazany do zadań potomnych. Ten prosty mechanizm stanowi formę komunikacji między zadaniami. Zadanie może bowiem ustawiać wartości swoich parametrów w trakcie działania, np. można w zadaniu Paczkowe polecenia SQL dodać parametr „Parametr1” i zastosować skrypt SQL ustawiający jego wartość:
Parametr1 = SELECT TOP 1 x FROM y WHERE […]
Wartość tego parametru można następnie użyć w zadaniach potomnych korzystając z mechanizmu wypełniania parametrów (patrz wyżej):
Argument= {Parametr1}
Wspólne parametry wszystkich zadań
Wszystkie zadania w Systemie mają kilka właściwości wspólnych (wyświetlanych w sekcji Parametry podstawowe w panelu Właściwości), z których większość jest dostępna jedynie do celów kontrolnych, tzn. istnieją wygodniejsze sposoby edycji lub zmiana wartości nie ma sensu. Wyróżniono właściwości, których edycja znajduje rzeczywiste zastosowanie.
| Parametry | |
|---|---|
| Zadania potomne | Lista nazw zadań-następników. Informacja prezentowana jest także jako strzałki łączące zależności, gdyż właśnie za pomocą strzałek najwygodniej ją edytować. |
| Opis | Opis słowno-muzyczny zadania w kontekście Systemu. Służy innym osobom pracującym z definicjami Systemu, a także jest wypisywany w tzw. Autodokumentację. |
| Nazwa | Nazwa zadania – dostępna też do edycji po zaznaczeniu zadania w grafie i naciśnięciu F2. |
| Parametry | Lista wszystkich wartości parametrów zadania, w tym parametrów propagowanych dalej, używanych (lub nie) przez zadanie, technicznych (np. o położeniu X-Y elementu na płaszczyźnie). |
| Wznawialne | Czy po wykryciu przerwania i wznowienia pracy managera zadań przez infrastrukturę, zadanie ma umożliwiać wznowienie (kontynuowanie pracy od momentu przerwania) czy ma być uruchamiane od początku. Ustawienie parametru należy przemyśleć w konkretnym zastosowaniu zadania, może się okazać że wznawianie zadania w szerszym kontekście nie ma sensu. |
| Status | Wartość statusu ustawiana dla nowych zadań. Od jakiegoś czasu nieużywana. Domyślnie: START_PENDING. |
| Typ | Typ zadania, wskazujący na pełną nazwę typu .NET i nazwę zestawu .NET. Napis postaci: „typeFullname;assemblyName”. Dla typowych zadań wypełniony z przybornika, dla zadań własnych systemu może (musi) być edytowany. |
| Status po błędzie | Dzięki tej opcji istnieje możliwość zamiany końcowego statusu zadania ERROR na inny. Np. w celu utworzenia zadań potomnych i kontynuowania przetwarzania. Można ustalić dowolny status, nie koniecznie jeden z listy: OK, WARNING, ERROR. |
| Status po ostrzeżeniu | Dzięki tej opcji istnieje możliwość zamiany końcowego statusu zadania WARNING na inny. Np. w celu wstrzymania przetwarzania. Można ustalić dowolny status, niekoniecznie jeden z listy: OK, WARNING, ERROR. |
Sytuacje błędne
Błędne zakończenie zadania w hierarchii zwykle, za pośrednictwem zależności, prowadzi do zatrzymania przetwarzania w Systemie.
Najczęstsze przyczyny błędów to:
- Brak wymaganego pliku wejściowego na dysku lub błąd połączenia do zasobu zdalnego.
- Błąd (konfiguracyjny) połączenia do bazy danych.
- Problem dostępności zasobów po stronie serwera – ilość pamięci, miejsce w logu transakcyjnym, miejsce na dysku na pliki wyjściowe itd.
W takich i podobnych sytuacjach, przetwarzanie hierarchii zadań będzie przerwane, informacja z logu będzie prezentować się następująco (po załadowaniu do środowiska projektowego). Informacja o uruchomieniu jest prezentowana na kilka sposobów (rysunek):
- kolorowe prostokąty wokół ikon zadań,
- właściwości zadań – teraz będą to informacje dot. uruchomienia (czasy, stan, komunikat, …),
- panel „podgląd tekstowy” – zwykle treść komunikatu jest dłuższa niż miejsce dostępne w liście właściwości.
Aktualnie prezentowane ID cyklu zmieniamy w pasku u góry panelu edytora hierarchii zadań. W przypadku wybrania wartości pustej widok powróci do trybu projektowania (właściwości definicji zadań, znikną kolorowe prostokąty itd…).
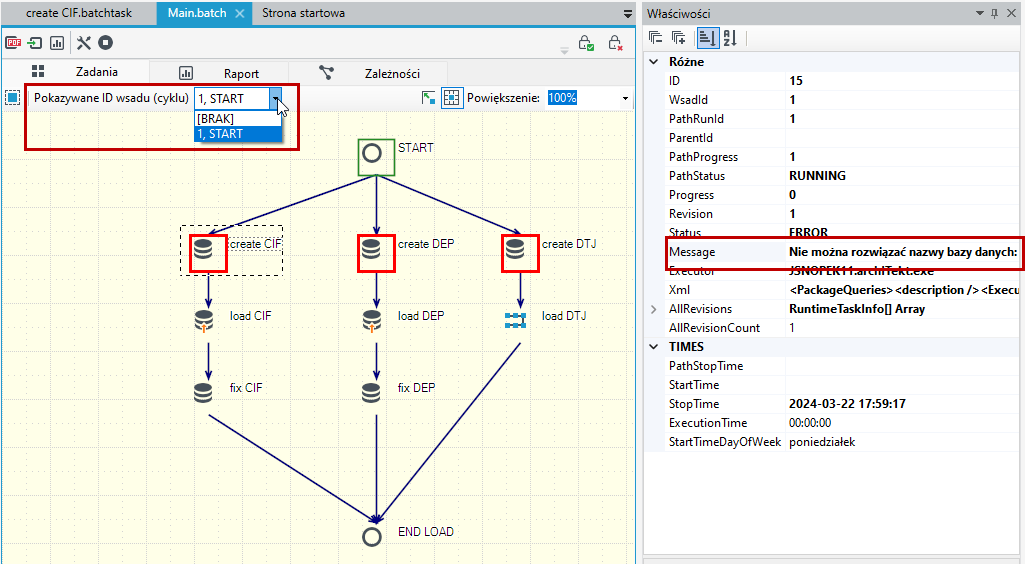
W prezentowanej sytuacji błąd polega na braku w konfiguracji definicji logicznej bazy danych. Po naprawieniu błędu, System nadal znajduje się w stanie jak na rysunku.
Aby to naprawić można wykonać kilka czynności, w zależności od dostępnych metod i planowanego rezultatu:
- Uruchomić całe przetwarzanie od nowa.
- Uruchomić tylko błędne zadania od nowa (ustawić stan START_PENDING).
- Spróbować kontynuować błędne zadania (ustawić stan RESUME_PENDING).
- Pominąć błędne zadania (i np. wcześniej wykonać ich treść samodzielnie) – ustawić status SKIP.
Pierwsze rozwiązanie zwykle spowoduje użycie kolejnego numeru cyklu (wsadu) co w niektórych systemach będzie problemem, jeśli ta wartość jest silnie związana z innymi elementami Systemu (np. oznacza cały miesiąc przetwarzania i nie przewiduje się duplikatów).
Pozostałe rozwiązania spowodują wykorzystanie wyższych tzw. numerów powtórki zadań w ramach tego samego cyklu.
-
Ponawianie zadania (RESUME_PENDING) przestawia zastane zadanie w status błędu ze stosownym komentarzem (i wpisuje w jego krótką wiadomość informację o wznowieniu i ID zadania następnego), a następnie wykonuje próbę ponowienia zadania. Większość zadań nie obsługuje wznawiania – wywołuje procedurę przetwarzania od początku.
-
Pominięcie zadania można zastosować zarówno do zadania już działającego, jak i zatrzymanego. W pierwszym przypadku zadanie zostanie siłowo zatrzymane. W obydwu przypadkach zostaną utworzone zadania potomne a samo zadanie pomijane wejdzie w stan ostrzeżenia (WARNING) ze stosownym komentarzem w polu wiadomości.
Opisane czynności zmiany statusów można wykonać na kilka sposobów:
- Wprost na bazie danych (SQL), na tabeli
TASKS. - Ze środowiska projektowego po podłączeniu do bazy danych i tabeli.
- Z ekranu aplikacji WWW (jeśli jest dostępny).
- Z ekranu aplikacji do Harmonogramowania.
- Przy pomocy programu
archITekt.Runner.exena odpowiednio skonfigurowanym środowisku.
Propagacja błędów z Przetwarzania danych
Przetwarzanie danych umożliwia uzyskanie wielu skomplikowanych sposobów, w których mogą powstawać błędy. Każdy z nich ma przypisany tzw. poziom błędu (im wyższy, tym poważniejszy).
- Np. błędy odwzorowań (wymagalność, parsowanie, słowniki) oznaczają poziom 3.
- Poziom 10 oznacza nieprzewidziany wyjątek w działaniu.
- Poziom 11 występuje po celowym przerwaniu działania pakietu po wykryciu poważnej awarii (np. naruszenie monotoniczności danych scalania).
Poziomy niektórych błędów można modyfikować na poziomie bloczka (obniżyć poziom wyjątków) lub reguł walidacyjnych (adnotacja dostępna w bloczku odwzorowania w miejscu).
- Informacja o maksymalnym występującym poziomie błędu oraz ilości błędów na poszczególnych poziomach steruje stanem końcowym i komunikatem zadania. Służy do tego właściwość Definicja statusu końcowego, umożliwiająca skonfigurowanie „drabinki” kolejnych warunków na ilość i poziom błędu.
Domyślna konfiguracja powoduje ustawienie statusu WARNING po wystąpieniu przynajmniej jednego błędu poziomu 9 i statusu ERROR przy przynajmniej jednym błędzie poziomu 10.
Po zakończeniu przetwarzania pakietu do komunikatu trafia informacja o ilości błędów i ostrzeżeń.