Szczegółowy opis zadań
Zadania są zdefiniowane w klasach .NET (można łatwo pisać własne przeciążając jedną klasę). System „w pudełku” oferuje kilka bardzo użytecznych zadań o bogatych możliwościach konfiguracji.
Zadania umieszczone są na karcie Przybornik, skąd możesz je przeciągać na obszar roboczy a następnie łączyć.
| Ikona | Funkcja |
|---|---|
 | Bulk Copy - zadanie łączy ze sobą strumień odczytu danych z tabel dowolnej bazy z szybką metodą zapisu danych do MS Sql Servera (BULK COPY PROTOCOL). |
 | Bulk Insert - zadanie odczytuje pliki tabelaryczne (oddzielane np. CSV) i zapisuje je metodą szybką (BULK COPY PROTOCOL) do tabel MS Sql Server. |
 | Skrypt powłoki - zadanie uruchamiające skrypt interpretowany przez powłokę (domyślnie cmd.exe). |
 | Transport plików - zadanie umożliwia pobranie z bazy/wstawienie do bazy treści plików danych. Obsługuje pola typu CLOB (BLOB, RAW, itp.). |
 | Zadanie c# - inne zadanie zdefiniowane w kodzie systemu, nieposiadające własnej, dedykowanej ikony. Może realizować całkowicie dowolne funkcje, definicja wymaga znajomości programowania w .NET i obsługi kompilatora. |
 | Paczkowe polecenia SQL - umożliwia iterowanie po tabeli i wykonywanie „paczkami” parametrycznych poleceń SQL. Umożliwia też wykonywanie całkiem zwyczajnych zapytań SQL (np. DML). Najpopularniejsze zadanie używane w systemach. |
 | Raport SQL - przygotowuje proste raporty na podstawie wzorca tekstowego, wypełniając elementy szablonowe wynikiem dowolnego zapytania SQL. |
 | Załóż blokadę plikową: zadanie zakłada blokadę plikową służącą do synchronizacji wykonywania zadań. |
 | Zdejmij blokadę plikową: zadanie zdejmuje blokadę plikową służącą do synchronizacji wykonywania zadań. |
 | Pakiet przetwarzania danych - umożliwia definicję rozbudowanych transformacji danych. |
 | Paczkowy pakiet przetwarzania danych - umożliwia uruchomienie Masowego Przetwarzania Danych w paczkach, iterując po przedziałach kluczy wskazanej tabeli bazy danych. Klucze iteracji (od-do) są przekazywane jako argumenty wywołania pakietu. |
 | Adnotacja tekstowa: umożliwia dodawanie opisów (komentarzy) w ramach tworzonej hierarchii zadań. |
| Kopiowanie przyrostowe - zadanie utrzymuje w drugiej bazie aktualną, przyrostowo aktualizowaną kopię jednej lub wielu tabel. |
Definicja zadania zwykle składa się z dwóch elementów:
- wartości parametrów - patrz: Zadania>Parametry zadań,
- plik skryptu zadania – plik wskazany przez jeden z parametrów ( o nazwie „FileName”), a w przypadku jego braku, przez nazwę zadania, w katalogu wskazanym przez globalny parametr DefaultDirName, a w przypadku jego braku w katalogu startowym Aplikacji.
Zwykle parametr FileName nie jest używany, jednak można go zastosować dla uzyskania efektu: wiele zadań, jeden skrypt. Dokładnie w ten sposób działa wklejanie z referowaniem do skryptu oryginalnego (obok wklejania z klonowaniem skryptu) – są to opcje dostępne w menu kontekstowym edycji hierarchii zadań po skopiowaniu zadania lub zadań do schowka.
Treść skryptu może też być osadzona w treści hierarchii zadań, jednak nie jest to często stosowane (opcje dostępne w menu kontekstowym zadania).
Bulk Insert
Zadanie odczytuje pliki tabelaryczne (oddzielane np. CSV) i zapisuje je metodą szybką (BULK COPY PROTOCOL) do tabel MS Sql Server.
Może wykonywać dodatkowo:
- bardziej złożone parsowanie typów danych (nietypowych dat, kwot, flag logicznych),
- próbkować dane do celów testowych – ładować co N-ty wiersz z ograniczeniem do M rekordów,
- rozpoznawać nieprawidłowości w rekordach i odrzucać je do pliku błędów (wymaga włączenia).
| Parametry zadania | |
|---|---|
| Kodowanie znaków | Kodowanie pliku wejściowego – do wyboru lista najpopularniejszych kodowań: ISO-8859-2 (Latin2), Mazovia, Windows 1250, UTF-8, UTF-16. Ustawienie „OTHER” powoduje że do głosu dochodzi wartość parametru „Encoding”. |
| Rozszerzone kodowanie znaków | Numer kodowania .NET. (patrz: Opis działania systemu > Strony kodowe) |
| Rozmiar wsadu | Rozmiar pojedynczej paczki (transakcji) protokołu Bulk Copy. |
| Plik wejściowy | Fragment ścieżki do pliku danych, postaci: podkatalog\plik.rozszerzenie;KATALOG, gdzie: podkatalog jest opcjonalny, może występować dłuższa ścieżka, katalog jest logiczną nazwą katalogu danych, rozwiązywaną poprzez konfigurację, można używać szablonów parametrów w postaci {ParamN} – (patrz: Zadania>Parametry zadań) Powyższe reguły dotyczą wszystkich ścieżek podawanych jako wartości parametrów. |
| Timeout | Time out połączenia do bazy docelowej [s]. |
| Baza danych | Nazwa logiczna bazy docelowej. W razie braku wartości, będzie użyta wartość globalnego parametru ‘DefaultDbName’. |
| Plik na błędy | Ścieżka do pliku z błędnymi rekordami. |
| Separator pól | Ciąg znaków oddzielających kolumny w pliku danych. Można wpisywać sekwencje specjalne: \t |
| Znak cudzysłowu | Opcjonalny ciąg znaków otaczających wartość, np. ’’ |
| ReadFileHeader | Opcja wczytywania schematu danych z linii nagłówka. Jeśli nie, zostanie użyty tylko dokładny schemat zdefiniowany w skrypcie. |
| Prefiks pól | Wspólny prefiks pól tabeli używany do mapowania z nagłówka pliku. Odwzorowanie ma miejsce jeśli nazwa kolumny pliku pozbawiona tego prefiksu zgadza się z elementem nagłówka. |
| Czyszczenie tabeli docelowej | Opcja umożliwiająca przed ładowaniem danych obcięcie całej zawartości tabeli docelowej. |
| W przypadku błędu | Domyślny rodzaj czynności podejmowanej podczas napotkania błędnego rekordu, np. za długiej wartości napisowej, numerycznej, nie będącej datą. Dla konkretnych pól można ustawić specyficzne wartości w odpowiedniej sekcji pliku konfiguracyjnego zadania. Dostępne możliwości: NONE - Brak walidacji i kontroli treści. Dane przesyłane są prosto do implementacji ładowania. Jest to najszybszy wariant, ale wystąpienie błędu w danych powoduje momentalne zatrzymanie przetwarzania; SKIP - Pominięcie błędnego wiersza - odrzucenie do pliku z błędami. Pozostałe wiersze zostaną wczytane; RECOVER - Wartości błędne i puste zostaną zamienione na domyślne (zero, pusty napis, datę bieżącą). |
| Dopuszczalna liczba naprawionych | Maksymalna dozwolona liczba uratowanych linii, w których przynajmniej jedno pole zostało uzupełnione wartością domyślną. Jeżeli liczba zostanie przekroczona, to zadanie zakończy się w statusie ERROR. Domyślnie ustawiona jest wartość UNLIMITED, czyli liczba błędów nie ma wpływu na status końcowy zadania. Przekroczenie ustawionego progu nie przerywa natychmiast działania zadania. Chodzi o to, aby przy zakończeniu ładowania uzyskać pełną informację o ilości wszystkich błędów, a nie tylko początkowych (odciętych wartością parametru). Wystąpienie przynajmniej jednego błędu (bez przekraczania progu) powoduje zakończenie zadania w stanie WARNING. |
| Dopuszczalna liczba pominiętych | Maksymalna dozwolona liczba odrzuconych linii podczas walidacji danych przed zapisem. Jeżeli liczba zostanie przekroczona, to zadanie zakończy się w statusie ERROR. Domyślnie ustawiona jest wartość UNLIMITED, czyli liczba błędów nie ma wpływu na status końcowy zadania. Przekroczenie ustawionego progu nie przerywa natychmiast działania zadania. Chodzi o to, aby przy zakończeniu ładowania uzyskać pełną informację o ilości wszystkich błędów, a nie tylko początkowych (odciętych wartością parametru). Wystąpienie przynajmniej jednego błędu (bez przekraczania progu) powoduje zakończenie zadania w stanie WARNING. |
| Próbkowanie danych do testów | |
|---|---|
| SampleEveryNth | Ogranicznik ilości rekordów - wczytujemy co N-ty rekord |
| SampleRowLimit | Ogranicznik ilości ładowanych rekordów |
| Parsowanie wartości – ustawienia domyślne | |
|---|---|
| DefaultBoolParser | Specyfikacja formatu wartości logicznych: Bool |
| DefaultDateParser | Specyfikacja formatu dat, np. Date(yyyyMMddHHmmss) |
| DefaultDecimalParser | Specyfikacja formatu liczb stałopozycyjnych, np. Decimal(.) |
Treść przykładowego skryptu.
#DESTINATION_TABLE
loading.IBS_CIF

#FILE_HEADER
ACN|ZSYPLN|BOO|CC|CIFCLCD|DLC|LFU|CIFOFF|DAO|DEP|DOB|DOD|EDUC|FAXNUM|LNM| …

#MAPPINGS
ZSYPLN, TARGET_ZSY

#FIELD_TYPES
ZHCV Decimal(.)
DTD1 Date(yyyy/MM/dd)

#FIELD_VALIDATION
CIFCLCD, SKIP
CIFOFF, RECOVER
FAXNUM, NONE
Sekcje skryptu:
#DESTINATION_TABLE– nazwa tabeli docelowej.#FILE_HEADER– nagłówek pliku wejściowego w postaci oryginalnej (separowanej). Służy do identyfikacji kolumn w przypadku gdy nagłówek nie występuje w pliku danych.#MAPPINGS– odwzorowanie nagłówków kolumn pliku w kolumny tabeli. Może zostać pominięte jeśli kolumny pasują (z uwzględnieniem wartości parametru TablePrefix).#FIELD_TYPES– służy do podłączania informacji o formacie wartości do konkretnych pól wejściowych,#FIELD_VALIDATION– w sekcji można określić sposób walidacji na poziomie pojedynczego pola. Dostępne typy walidacji są takie same jak w parametrzeValidationErrorAction– NONE, SKIP i RECOVER. Sposób walidacji określony dla konkretnej kolumny przesłania wartość określoną ogólnie dla całej tabeli (przez parametrValidationErrorAction).
Dopuszczalne parsery pól (wartości parametrów Default Parser oraz specyfikacje w sekcji #FIELD_TYPES):
- Bool(x), gdzie x jest domyślną wartością zwracaną w przypadku niemożności wczytania wartości. Np. bool(1), bool(). Ostatnia wartość zwróci wartość pustą.
- Decimal(separatory), gdzie „separatory” to ciąg znaków, z których każdy jest traktowany jak separator dziesiętny, a pozostałe znaki są POMIJANE (z wyjątkiem następujących:
–eE). Zwykle używa sięDecimal(.)lubDecimal(,), ale dopuszczalne są też zapisyDecimal(,.)
Użycie niewłaściwego separatora spowoduje wczytanie liczby z pominiętym znakiem separatora dziesiętnego (czyli liczby za dużej).
- DecimalExact(separator), gdzie „separator” to ciąg znaków występujący jako separator dziesiętny. Zwykle będzie
DecimalExact(.)lubDecimalExact(,)Użycie niewłaściwego separatora (podobnie jak wystąpienie niedozwolonych znaków w wartości) spowoduje wystąpienie błędu formatu danych. Sposób obsługi błędu zależy od ustawienia właściwości „ValidationErrorAction” - Date(format), gdzie format składa się z liter oznaczających fragmenty daty. Szczegółowy opis znaczenia liter: http://msdn.microsoft.com/en-us/library/8kb3ddd4.aspx.
Skrót poniżej:
- yyyy – rok 4 cyfrowy,
- MM – miesiąc,
- dd – dzień,
- HH – godzina (format 24h),
- mm – minuty,
- ss – sekundy.
Bulk Copy
Zadanie łączy ze sobą strumień odczytu danych z tabel dowolnej bazy z szybką metodą zapisu danych do MS Sql Servera (BULK COPY PROTOCOL).
Umożliwia np. sprawne przenoszenie dużych fragmentów danych (lub całych tabel) pomiędzy bazami. Z powodzeniem jest stosowane do klonowania całych hurtowni danych pomiędzy bazami w architekturach DB/2 z/OS a MS SQL Serwer.
| Parametry zadania | |
|---|---|
| Rozmiar wsadu | Rozmiar pojedynczej paczki (transakcji) protokołu Bulk Copy. |
| Timeout celu | Time out połączenia do bazy docelowej (MS Sql) [s]. |
| Baza docelowa | Nazwa logiczna bazy docelowej. W razie braku wartości, będzie użyta wartość globalnego parametru ‘DefaultDbName’. |
| Timeout źródła | Time out połączenia do bazy źródłowej (MS Sql) [s]. |
| Baza źródłowa | Nazwa logiczna bazy źródłowej. Parametr musi mieć ustawioną wartość. |
| Czyszczenie tabeli docelowej | Zapytanie czy przed ładowaniem danych należy obciąć całą zawartość tabeli docelowej. |
Treść przykładowego skryptu:
#SOURCE_QUERY
SELECT   KLDO_PESEL,  KLDO_DOK_KOD,  KLDO_DOK_NUM,  KLPROD_ID_PRODUKTU,  KLPROD_UDO_WSK, KLPROD_UDO_DATA_P,  KLPROD_UDO_OKRES,  KLPROD_UDO_WSK_B
FROM BKK.KLIENT
INNER JOIN BKK.DANE_OSOB
ON KL_ID_DANE_OSOB = KLDO_ID_DANE_OSOB
INNER JOIN BKK.KLIENT_PRODUKTY
ON KL_ID_KLIENTA = KLPROD_ID_KLIENTA
WHERE KL_WSK='A' AND KLPROD_AKT='A' AND KLPROD_TYP='WL'

#DESTINATION_TABLE
dbo.BKK_KLIENCI_BUF_DUPL

#MAPPINGS
KLDO_PESEL, PESEL
KLDO_DOK_KOD, KLDO_DOK_KOD
KLDO_DOK_NUM, KLDO_DOK_NUM
KLPROD_ID_PRODUKTU, PROD_ID_PRODUKTU
KLPROD_UDO_WSK, KLPROD_UDO_WSK
KLPROD_UDO_DATA_P, KLPROD_UDO_DATA_P
KLPROD_UDO_OKRES, KLPROD_UDO_OKRES
KLPROD_UDO_WSK_B, KLPROD_UDO_WSK_B
Sekcje:
#SOURCE_QUERY– treść zapytania do bazy źródłowej#DESTINATION_TABLE– nazwa tabeli w bazie docelowej#MAPPINGS– odwzorowania kolumn źródłowych w docelowe.
Skrypt powłoki
Zadanie umożliwia uruchamianie skryptów shell’a, głównie CMD i POWERSHELL. Posiada możliwość wskazania ścieżki do własnego interpretera poleceń.
Wewnątrz skryptu można umieścić własne parametry, które przed uruchomieniem zostaną podmienione na konkretne wartości. Format parametrów treści skryptu zdefiniowany jest poprzez właściwość ParameterFormat.
- Zadanie zakończy się z błędem, jeżeli na standardowym wyjściu błędów pojawią się jakiekolwiek dane (domyślne zachowanie można zmienić przy pomocy właściwości – patrz tabelka).
| Nazwa parametru | Opis |
|---|---|
| Interpreter | Rodzaj interpretera - można podać ścieżkę do pliku <exe> Domyślnym interpreterem jest cmd.exe |
| Argumenty | Argumenty interpretera. W przypadku powershell'a puste argumenty są automatycznie zamieniane na: -command \"-\" (czytanie danych ze standardowego wejścia). |
| Katalog roboczy | Katalog roboczy, z poziomu którego zostanie uruchomiony skrypt. Można podać ścieżkę absolutną do katalogu, lub nazwę katalogu z konfiguracji, poprzedzoną średnikiem. |
| Format parametrów wejściowych | Wyrażenie regularne, na podstawie którego identyfikowane są parametry w skrypcie. Domyślnie parametry przyjmują formę: #(nazwa_parametru)# |
| Plik wyjściowy | Ścieżka do pliku, w którym zostanie zapisany wynik działania skryptu. Nie jest wymagana, ponieważ dane wyjściowe są zapisywane również w logach i w Message samego zadania. |
| Maksymalna długość loga | Maksymalna ilość wierszy strumienia wyjściowego i strumienia błędów, które zostaną zapisane w logu aplikacyjnym. |
| Maksymalna długość informacji | Maksymalna ilość wierszy strumienia wyjściowego i strumienia błędów, które zostaną zapisane w polu 'Message' zadania. |
| Status przy błędach | Status, który przyjmie zadanie w przypadku otrzymania jakichkolwiek danych na standardowym wyjściu błędów. Domyślnie ERROR. Stan „BŁĄD” jest wykrywany gdy na standardowym wyjściu błędów pojawi się jakiś tekst. Przykład dla powłoki powershell: Write-Error ”Some error message” Przykład dla cmd.exe: echo Error message >&2 |
Przykładowy skrypt obrazujący użycie parametrów zewnętrznych:
xcopy #(DATA)#_CONTRADR.TXT # (TECH)#\#(BANK)#\ /S /I /F /R /K /Y
xcopy #(DATA)#_CUSTDATA.TXT # (TECH)#\#(BANK)#\ /S /I /F /R /K /Y
xcopy #(DATA)#_CONTCUST.TXT # (TECH)#\#(BANK)#\ /S /I /F /R /K /Y
xcopy #(DATA)#_SCHEDULE.TXT # (TECH)#\#(BANK)#\ /S /I /F /R /K /Y
dir # (TECH)#\#(BANK)#\
Transport plików
Zadanie umożliwia pobranie z bazy / wstawienie do bazy treści plików danych. Obsługuje pola typu CLOB (BLOB, RAW itp.).
- File Transport Task jest zadaniem transportującym pliki z bazy na dyski i z dysku do bazy danych. Zadanie posiada możliwość pakowania i rozpakowywania pliku w locie podczas transportu - za pomocą algorytmu ZIP. Jedno zadanie umożliwia transport większej ilości plików.
| Parametry zadania | |
|---|---|
| Nazwa bazy danych | Nazwa bazy danych będącej źródłem lub celem transportu pliku. |
| FileName | Ścieżka do pliku skryptu opisującego dalsze szczegóły procesu transportowego. |
| Typ akcji | Typ wykonywanej akcji. Są dwie możliwości: - transport do bazy z dysku – Upload, - transport na dysk z bazy Unload |
Treść przykładowego skryptu:
#TABLE
0:TABELA_NA_PLIKI
1:TABELA_NA_PLIKI

#DATA_COLUMN
0:F_CONTENT
1:F_CONTENT

#FILE_NAME
0:FilePath1
1:FilePath2

#KEY_COLUMN
0:F_ID
1:F_ID

#KEY_VALUE
0:Log:Id
1:Korekta:Id

#FILE_TRANSFORMATION
0:UNZIP
1:UNZIP
Skrypt podzielony jest na sekcje. Każda sekcja musi posiadać podpunkty numerowane (przynajmniej jeden) dla każdego transportowanego pliku.
#TABLEDefinicja tabel do których mają być wgrywane lub z których będą pobierane pliki.#DATA_COLUMNnazwy kolumn do przechowywania kolejnych transportowanych plików.#FILE_NAMEścieżki źródłowe lub docelowe dla transportowanych plików.#KEY_COLUMNkolumna klucza głównego tabeli przechowującej pliki. Potrzebna przy wykonaniu odpowiedniego zapytaniaSELECTlubUPDATE#KEY_VALUEwartość klucza głównego dla zapytania pobierającego lub zapisującego plik do bazy.#FILE_TRANSFORMATIONewentualna transformacja dokonywana w locie na pliku podczas transportu. W tym momencie możliwe tylko pakowanie bądź rozpakowywanie algorytmem ZIP. Sekcja nie jest wymagana.
Paczkowe polecenia SQL
Zadanie umożliwia iterowanie po tabeli i wykonywanie „paczkami” parametrycznych poleceń SQL. Umożliwia także wykonywanie zwyczajnych zapytań SQL (np. DML). Najpopularniejsze zadanie używane w systemach.
Przetwarzanie obejmuje 3 fazy:
- wstępna – przed zapytaniami paczkowymi,
- paczkowa,
- końcowa – po zapytaniach paczkowych.
| Parametry konfiguracyjne | |
|---|---|
| Sprawdzanie typu klucza | Umożliwia sprawdzenie typu klucza na etapie walidacji (techniczne, dla kompatybilności wstecznej). Domyślnie: False. |
| Timeout | Parametr 'Timeout' poleceń SQL, wyrażony w sekundach. Domyślnie: 1 godzina (przygotowanie do długotrwałych poleceń). |
| Baza danych | Nazwa logiczna bazy danych, na której będą wykonywane zapytania. Pusta wartość spowoduje, że będzie użyty globalny parametr 'DefaultDbName'. |
| Ostatnio wykonane | ID początkowe ostatnio wykonanej paczki. Wartość używana w zaawansowanych scenariuszach do wznawiania szczególnie długotrwałych zadań. |
| Częściowe wznawianie | Opcja umożliwia wybór, czy wznawianie zadania ma być kontynuowane od miejsca ostatniej skutecznie wykonanej paczki. Jeśli nie, wznawianie wykona ponowne uruchomienie od początku. |
Treść przykładowego pliku skryptu:
#TABLE
TMP_CURR_MIRROR_ACC
#COLUMN
TMPCA_ID
#PKG_QTY
1000
#QUERIES
0:  insert into TMP_CURR_MIRROR_CLI (#DSTCOLUMNS(TMP_CURR_MIRROR_CLI, TMPCC_)#)
  select #SRCCOLUMNS(CLIENTITEM_CURR, CLIIT_)#
  from TMP_CURR_MIRROR_ACC (nolock)
  join CLIENTITEM_CURR (nolock)
  on TMPCA_BRANCH=CLIIT_BRANCH
  and TMPCA_TRANSID=CLIIT_TRANSID
  and TMPCA_TRANS_TYPE=CLIIT_TRANS_TYPE
  and TMPCA_FILE=CLIIT_FILE
  and CLIIT_FILE <> 1
  where not exists (
  select 1 from ERRORS_K (nolock)
  where ERR_TR_ID=TMPCA_TR_ID
  and ERR_CLI_LINE=CLIIT_LINE
  )
  and TMPCA_ID between @lowBound and @highBound
  and CLIIT_WSAD_ID=SRC_ID
#PREPARING_QUERIES
0:  SRC_ID = SELECT max(WSAD_ID) FROM WSAD WHERE WSAD_VISIBLE=1
1:  ? drop table TMP_CURR_MIRROR_CLI
2:  create table TMP_CURR_MIRROR_CLI
  [...]
W edytorze, w sekcjach można używać podpowiadania składni, aktywowanego klawiszami Ctrl+Spacja.
Kolejne zapytania SQL należy oddzielić numerem zapytania + dwukropkiem, lub tylko znakiem dwukropka (można pominąć numer).
Sekcje skryptu:
PREPARING_QUERIES- zapytania wykonywane przed zapytaniami „paczkowymi”,TABLE– nazwa tabeli, po której następuje iteracja „paczkami”,COLUMN– nazwa kolumny, po której następuje iteracja „paczkami”,PKG_QTY– ilość paczek,QUERIES– treści zapytań paczkowych (patrz niżej),CLOSING_QUERIES- treści zapytań końcowych, wykonywanych po iteracji „paczkami”.
W zapytaniach paczkowych można korzystać z kilku rozszerzeń:
- Parametr
@lowBoundlub#MIN– dolna granica bieżącej paczki, - Parametr
@highBound lub#MAX– górna granica bieżącej paczki.
Nie ma żadnej różnicy pomiędzy tymi rozszerzeniami, jednak obecnie zalecane jest stosowanie wartości #MIN lub #MAX, natomiast ze względów „Historycznych” wartości @lowBound i @highBound również jest poprawne.
W zapytaniach wszędzie można korzystać z kilku rozszerzeń:
#BatchId– wartość bieżącego ID cyklu przetwarzania,#TaskId– ID bieżącego zadania w środowisku uruchomieniowym,#TaskRevision– numer powtórki zadania,#TaskName – nazwa zadania,#ParamN– wartość napisowa parametru N dostępnego w momencie uruchomienia zadania (określonego na zadaniu lub odziedziczonego z zadań poprzednich).
Można też korzystać z wymienionych parametrów za pomocą składni ##ParamN – wówczas wartość parametru zostanie wstawiona literalnie, do tekstu zapytania. Wariant z pojedynczym znakiem # wstawia do zapytania parametr. Możliwość ta jest przydatna do uzyskiwania jednego szablonu skryptu uruchamianego dla wielu nazw tabel czy kolumn, różniących się np. tylko sufiksem nazwy.
Ponadto, plany zapytań SQL zawierających stałe wartości zamiast parametrów SQL mogą zostać przez serwer przygotowane jako bardziej optymalne.
Zaawansowane rozszerzenia:
-
#SRCCOLUMNS(TabelaA, PrefixA [, Omit1 [, Omit2 …]] )# -
#DSTCOLUMNS(TabelaB, PrefixB [, Omit1 [, Omit2 …]] )#Wyrażenia rozwijane w listę nazw kolumn tabeliA oraz tabeli - kolejno dla kolumn występujących w obydwu tabelach (dopasowanie z pominięciem specyficznych dla tabel prefiksów), opcjonalnie z pominięciem kolumn wymienionych jako OmitN. Przydatne do automatycznego formatowania długich zapytań typu
INSERTdotyczących bardzo rozbudowanych schematów tabel. -
#SET#- analogia do powyższego, dotyczy zapytańUPDATE, gdzie klauzula będzie rozwinięta do listy a1=b1, a2=b2, a nazwy tabel źródłowej i docelowej będą pobrane z treści reszty zapytania.
Raport SQL
Przygotowuje proste raporty na podstawie wzorca tekstowego, wypełniając elementy szablonowe wynikiem dowolnego zapytania SQL.
| Parametry zadania | |
|---|---|
| Typowe kodowanie znaków | Kodowanie pliku wejściowego – do wyboru lista najpopularniejszych kodowań: ISO-8859-2 (Latin2), Mazovia, Windows 1250, UTF-8, UTF-16. Ustawienie „OTHER” powoduje że do głosu dochodzi wartość parametru „Encoding” |
| Kodowanie znaków | Numer kodowania .NET (patrz: Opis działania systemu >Strony kodowe) |
| Timeout | Time out połączenia do bazy [s] |
| Separator kolumn | Ciąg znaków oddzielających kolumny w pliku danych. Można wpisywać sekwencje specjalne: \t |
| Baza danych | Nazwa logiczna bazy danych. W przypadku nie wypełnienia wartości będzie użyta baza wskazana przez globalny parametr „DefaultDbName”. |
| Plik wyjściowy | Nazwa pliku wyjściowego raportu (postaci zwykłej ścieżki-parametru: podkatalog\plik.csv;KATALOG). |
| Obcinanie pustych wartości | Czy obcinać wartości puste z brzegów napisów wyjściowych? Bardzo przydatne dla pól typu „CHAR(n)” – o stałej długości uzupełnianej spacjami. |
Przykładowy skrypt zadania:
#REPORT_TEMPLATE
Raport poprawnosci nowego wsadu:
* Ilosc rachunkow nowego lustra: {0}
* Ilosc klientow nowego lustra: {1}
* Ilosc rachunkow starego lustra: {2}
--------------------------------------------------
Zawartość tabeli WSAD:
{3}
#PARAMS
0:  select b2it_wsad_id, count(*) as Ile from bik2_item group by b2it_wsad_id

1:  select b2cliit_wsad_id, count(*) as Ile from bik2_clientitem group by b2cliit_wsad_id
2:  declare @old_acc_mirror varchar(50);
  select top 1 @old_acc_mirror = name from sys.objects where name like 'BIK2_ITEM_OLD%' order by create_date desc;
  EXEC('select b2it_wsad_id, count(*) as Ile from ' + @old_acc_mirror + ' group by b2it_wsad_id')
3:  select top 20 * from WSAD order by WSAD_ID desc
Sekcje skryptu:
-
#REPORT_TEMPLATE– szablon raportu. Odnośniki do danych mają postać{n}, gdzie n jest numerem zapytania z sekcji #PARAMS. W wersji minimalnej może mieć postać{0}Jeśli wynikiem jest pojedyncza wartość skalarna, będzie wstawiona jako taka.
Jeśli wynikiem jest tabela, zostanie dołączony nagłówek w pierwszej linii.
-
#PARAMS– kolejne numerowane zapytania, których wyniki należy podstawić pod odnośniki w sekcji#REPORT_TEMPLATE
Zadanie nadaje się do generowania raportów nadających się do otwierania przez program Microsoft Office Excel – w tym celu należy nazwać plik tak, aby miał rozszerzenie „.xls” oraz zdefiniować prosty szablon raportu zawierający jedynie: {0}
Paczkowy pakiet przetwarzania danych
Zadanie Paczkowy pakiet Masowego Przetwarzania Danych służy do uruchomienia zadania Pakiet Masowego Przetwarzania Danych pewną ilość razy.
- Ilość uruchomień jest wyznaczana na podstawie zakresu danych występujących, w określonej w parametrach zadania, kolumnie tabeli w bazie danych.
- Wykonanie zadania rozpoczyna się od pobrania minimalnej i maksymalnej wartości w kolumnie podanej w parametrze Nazwa kolumny klucza należącej do tabeli z parametru Nazwa tabeli kluczaz bazy określonej w parametrze Baza. Wskazana kolumna musi być typu liczbowego (np.; int, bigint, numeric, decimal, float) lub być wyrażeniem SQL dającym taki typ wyniku. Dopuszczalny jest również typ tekstowy, ale Użytkownik musi się upewnić, że dane w tej kolumnie są liczbami i są zapisane w takiej postaci aby poprawnie zadziałały operatory SQL min i max (np. wyrównane do takiej samej długości za pomocą wiodących zer). W parametrze Nazwa tabeli klucza może być podana nazwa tabeli lub podzapytanie SQL w postaci dającej się użyć w klauzuli FROM.
- Zakres wartości od minimalnej do maksymalnej dzielony jest na przedziały o długości równej parametrowi Maksymalny rozmiar paczki (a w przypadku ostatniego przedziału – pozostałość zakresu). Należy podkreślić, że parametr ten nie określa ilości elementów w każdej paczce – może ich być mniej (nawet 0) albo więcej (jeżeli są duplikaty). Przedziały są zamknięte obustronnie, a różnica pomiędzy górną granicą poprzedniego przedziału, a dolną następnego wynosi 1. Należy to uwzględnić przy typie danych float, gdyż ze względu na zaokrąglenia może dojść do zgubienia elementów pomiędzy przedziałami. Dla każdego przedziału wykonywane są następujące działania w podanej kolejności:
- Wykonanie zapytania podanego w parametrze Przed pakietem (jeżeli podano jakieś).
- Wykonanie pakietu Masowego Przetwarzania Danych.
- Wykonanie zapytania podanego w parametrze Po pakiecie (jeżeli podano jakieś).
- W treści zapytań Przed pakietem i Po pakiecie można używać napisów
#MINi#MAX, zostaną one zamienione na początek i koniec aktualnego przedziału. - Wartości te mogą być również dostępne wewnątrz pakietu Masowego Przetwarzania Danych jeśli zostaną przekazane przez jego parametry uruchomieniowe. Aby to zrobić należy podać
{#MIN}lub{#MAX}jako wartość parametru uruchomieniowego.
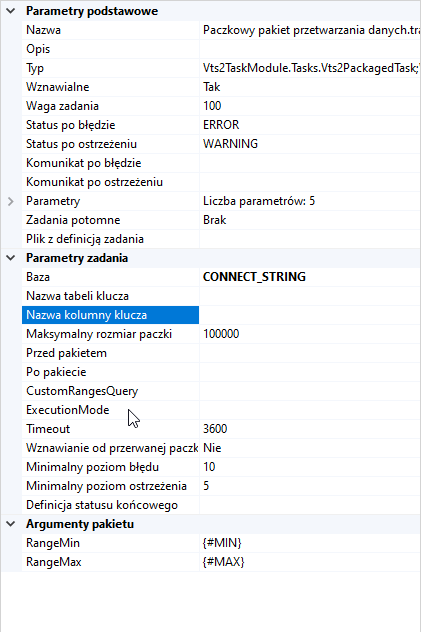
- Dopuszczalny czas wykonania zapytań znajdującego zakres danych, Przed pakietem i Po pakiecie można określić w sekundach w parametrze „Timeout”. Pozostałe parametry są parametrami zadania „Pakiet Masowego Przetwarzania Danych” i należy je wypełnić zgodnie z jego dokumentacją.
Parametry zadania
| Nazwa kolumny klucza | Nazwa kolumny lub wyrażenie, z którego zostanie pobrany zakres wartości. |
|---|---|
| Nazwa tabeli klucza | Nazwa tabeli lub podzapytanie, w którym znajduje się kolumna klucza. |
| Baza | Baza danych, w której znajduje się tabela klucza. |
| Przed pakietem | Zapytanie wykonywane przed każdym wykonaniem pakietu przetwarzania. |
| Po pakiecie | Zapytanie wykonywane po każdym wykonaniu pakietu przetwarzania. |
| Timeout | Maksymalny dopuszczalny czas wykonania zapytań określającego zakres danych, „Przed pakietem” i „Po pakiecie”. |
Pakiet przetwarzania danych
Zadanie służy do definiowania złożonych transformacji danych, obejmujących różne źródła danych, miejsca docelowe, odwołania do zewnętrznego kodu itp.
Zadanie przetwarzania do uruchomienia zwykle będzie wymagać ustawienia kilku elementów:
- argumentów wywołania (dla całego pakietu) – np. dat granicznych – prezentowane w sekcji ustawień Argumenty pakietu,
- wartości parametrów bloczków – np. ścieżek do plików – prezentowane w sekcji Bloczek:
<nazwa>(typ), - wartości parametrów wspólnych dla wszystkich zadań typu przetwarzanie danych.
Parametry dwóch pierwszych rodzajów, choć różnią się dla każdego zadania, są automatycznie rozpoznawane i prezentowane jako oddzielne parametry do ustawienia w panelu Właściwości.
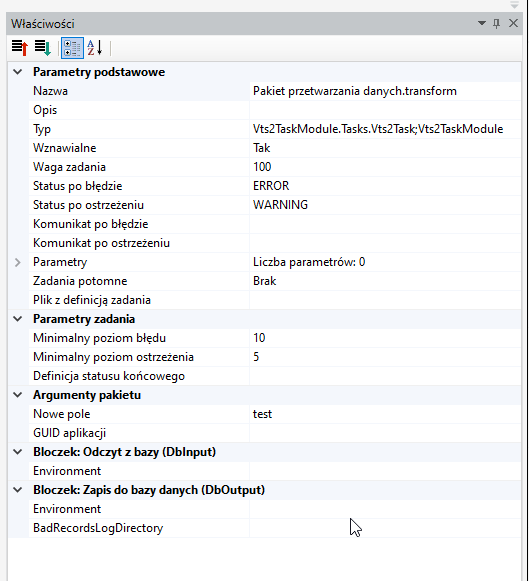
Parametry wspólne dla wszystkich zadań typu przetwarzanie danych:
| Parametry | |
|---|---|
| Minimalny poziom błędu | Minimalny poziom błędu powodujący zgłoszenie błędu z przetwarzania pakietu. Powoduje ustawienie statusu ERROR na zadaniu. Domyślnie: 10. Opcja jest dostępna jedynie wtedy, kiedy nie został zdefiniowany algorytm wyznaczania statusu końcowego FinishStatusDefinition. |
| Minimalny poziom ostrzeżenia | Minimalny poziom błędu powodujący zgłoszenie ostrzeżenia z przetwarzania pakietu. Powoduje ustawienie statusu WARNING na zadaniu. Domyślnie: 9. Opcja jest dostępna jedynie wtedy, kiedy nie został zdefiniowany algorytm wyznaczania statusu końcowego FinishStatusDefinition. |
| Definicja statusu końcowego | Definicja statusu końcowego, jaki przyjąć ma zadanie na koniec wykonania pakietu. Status określany jest na podstawie poziomu krytyczności napotkanych błędów oraz ich liczby. Ustawienie definicji powoduje wyłączenie stosowania parametrów MinErrorLevel i MinWarningLevel. Szczegółowy opis tej opcji znajduje się poniżej. |
Poziomy błędów i ostrzeżeń
Pakiet Masowego Przetwarzania Danych w trakcie działania zgłasza komunikaty o błędach. Każdy z takich komunikatów ma przypisany poziom błędu – im wyżej tym błąd poważniejszy.
- Np. wartość 10 oznacza nieoczekiwany wyjątek w przetwarzaniu,
- wartość 1 oznacz ostrzeżenie dotyczące mapowania wartości,
- wartość 3 odrzucenie rekordu z przetwarzania (bez zatrzymywania działania pakietu).
Pakiet w trakcie działania śledzi maksymalną wartość poziomu błędu.
- Aby przełożyć tą wartość na status zadania (OK, WARNING, ERROR) zostały zdefiniowane parametry ogólne: Minimalny poziom błędu, Minimalny poziom ostrzeżenia.
- Jeśli poziom błędu będzie >= Minimalny poziom błędu, zadanie zgłosi status wykonania ERROR, co będzie skutkowało przerwaniem gałęzi przetwarzania hierarchii zadań. Analogicznie – przekroczenie wartości Minimalny poziom ostrzeżenia ustawi status WARNING.
Definicja statusu końcowego - algorytm wyznaczania statusu końcowego zadania
- Definicja statusu końcowego domyślnie jest pusta, a znaczenie mają parametry Minimalny poziom błędu i Minimalny poziom ostrzeżenia.
- Oba parametry definiują w prosty sposób sytuacje, kiedy zadanie ma przyjąć statusy WARNING i ERROR.
- W przypadku ustalenia szczegółowej definicji statusu końcowego oba podstawowe parametry tracą swoje znacznie i ich wartości nie będą uwzględniane.
Do określenia algorytmu wyznaczania statusu końcowego służy edytor kolekcji pokazany na poniższym rysunku.
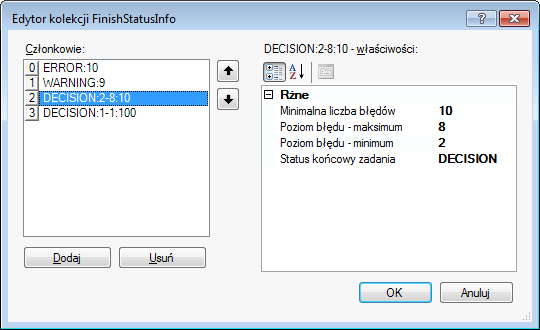
- Po lewej stronie widoczne są cztery zdefiniowane sytuacje. Algorytm wyznaczania statusu będzie analizował każdą z sytuacji w kolejności „od góry”.
- W przypadku, gdy liczba i poziom błędów w pakiecie spowoduje, że któraś z sytuacji zostanie spełniona, to zwrócony zostanie status definiujący tę konkretną sytuację.
- Wszystkie kolejne sytuacje nie będą już wtedy analizowane.
- W przypadku, gdy żadna ze zdefiniowanych sytuacji nie zostanie spełniona, to zadanie otrzyma status końcowy OK.
- Prawa strona rysunku przedstawia szczegóły wybranej sytuacji. Można w niej określić przedział od minimalnego do maksymalnego poziomu błędu (wagi), oraz minimalną liczbę błędów z tego przedziału, konieczną do spełnienia tej sytuacji.
- Oczywiście można również sprecyzować status zadania, jaki zostanie zwrócony w tym konkretnym przypadku. Oprócz standardowych statusów spoczynkowych TaskManagera: OK, WARNING, ERROR, można również zdefiniować własne statusy (np. status DECISION jest właśnie takim statusem).
Biorąc pod uwagę powyższą przykładową definicję, zadanie zwróci status:
- ERROR, jeżeli będzie przynajmniej jeden błąd na poziomie 10 i wyższym,
- WARNING, jeżeli będzie przynajmniej jeden błąd na poziomie 9 i nie będzie błędów z większą wagą,
- DECISION, jeżeli będzie przynajmniej 10 błędów na poziomie od 2 do 8 lub przynajmniej 100 błędów na poziomie 1 i nie będzie żadnych błędów na poziomie wyższym od 8,
- OK, jeżeli nie zajdzie żadne z powyższych.
Typy parametrów – argumentów wywołania pakietów
Po stronie zadań parametry są wyłącznie napisami. Po stronie pakietów przetwarzania danych argumenty wywołania mają typy, często inne niż napisowe. W celu pogodzenia tej sytuacji można pod argumenty wywołania pakietu podłączyć adnotację Parser skonfigurowaną do stosownej zmiany typu wartości.
- Np. jeśli parametr ma wartości postaci „20100214” i oznacza datę (yyyyMMdd) przypisaną do parametru D2, pod argument wywołania można podłączyć parser Napis>Data ze stosownym formatem daty yyyyMMdd.
Domyślne wartości argumentów
W podobny sposób można rozwiązać problem parametrów posiadających wartość domyślną.
- Np. gdy pakiet przetwarzania może działać w kilku trybach, w zależności od ustawienia parametrów typu „wartość logiczna”, które są wymagalne na wejściu, a pożądane jest mieć pewien domyślny sposób wykonania pakietu.
- Można takim argumentom wywołania ustawić adnotację Wartość stała zawierającą domyślną wartość parametrów. W takiej sytuacji nie będzie trzeba ustawiać wartości parametru po stronie konfiguracji zadania.
Dodatkowe informacje patrz: Argumenty wywołania pakietu.
Kopiowanie przyrostowe
Zadanie Kopiowanie przyrostowe utrzymuje w drugiej bazie aktualną kopię jednej lub wielu tabel. Przy każdym uruchomieniu kopiuje tylko te wiersze, których kolumna przyrostu – znacznik czasu, rosnący klucz liczbowy albo rowversion SQL Servera – przesunęła się od poprzedniego przebiegu, ładuje je do tabeli roboczej po stronie celu i scala z tabelą docelową po jej kluczu głównym.
To zwyczajne zadanie harmonogramu: wskazujesz dwie bazy logiczne, podajesz listę tabel i ustawiasz cykliczność. W żadnej z baz nie trzeba niczego instalować, a źródło jest wyłącznie czytane.
Co robi, a czego nie robi
| Robi | Nie robi |
|---|---|
| Kopiuje nowe i zmienione wiersze oknami, bez przeładowywania całej tabeli | Nie używa CDC, replikacji, triggerów ani czytania logu |
| Scala po kluczu głównym celu, więc wiersz skopiowany ponownie jest aktualizowany, a nie dublowany | Nie zapewnia spójności transakcyjnej między tabelami – każda tabela jest przetwarzana niezależnie |
| Działa między różnymi silnikami baz (zob. Wsparcie silników) | Nie przenosi zmian DDL, indeksów, więzów ani zachowania IDENTITY |
| Opcjonalnie przenosi usunięcia, pełnym przebiegiem po kluczach źródła | Nie widzi samego usunięcia – znacznik czasu nie umie go wyrazić |
| Jest odporne na przerwanie w trakcie działania – żadne dane nie są przechowywane pomiędzy uruchomieniami | Nie skopiuje wiersza, w którym aktualizacja nie ruszyła kolumny przyrostu |
Jeśli potrzebujesz pełnego przeładowania tabeli przy każdym przebiegu, użyj zadania Bulk Copy. Jeśli potrzebujesz przetwarzania wiersz po wierszu, to zadanie dla pakietu przetwarzania danych.
Jak wygląda jedno uruchomienie
┌───────────────────────────────────┐
│   Baza źródłowa (tylko czytanie)  │
│                                   │
│      ┌──────────────────┐         │
│      │ Tabela źródłowa  │         │
│      └──────────────────┘         │
└───────────────────────────────────┘
                 │
                 │ 1. jedno okno wierszy
                 ▼
┌───────────────────────────────────┐
│         Baza docelowa             │
│                                   │
│  ┌───────────────────────┐        │
│  │   Tabela robocza      │        │
│  │     cel + _INC        │        │
│  └───────────────────────┘        │
│              │                    │
│              │ 2. MERGE           │
│              ▼                    │
│  ┌───────────────────────┐        │
│  │   Tabela docelowa     │◄────┐  │
│  └───────────────────────┘     │  │
│                                │  │
│  ┌───────────────────────┐     │  │
│  │    Tabela kluczy      │─────┘  │
│  │   cel + _INC_KEYS     │        │
│  └───────────────────────┘        │
└───────────────────────────────────┘
          ▲
          │ 3. tylko KeySweep:
          │    wszystkie klucze główne
          │
┌──────────────────┐
│ Tabela źródłowa  │
└──────────────────┘

4. DELETE wierszy bez pary
Tabela kluczy (_INC_KEYS) → Tabela docelowa
Kroki 1 i 2 powtarzają się dla kolejnych okien, aż tabela nadrobi zaległości. Kroki 3 i 4 wykonują się raz, na koniec tabeli, i tylko gdy DeleteMode ma wartość KeySweep.
Zadanie przetwarza Workers tabel równolegle, każdą na własnych połączeniach, i kończy się, gdy skończy się ostatnia. Cykliczność zapewnia harmonogram – jedno uruchomienie to jedna sesja nadrabiania.
Ruchome okno
Obie krawędzie okna pochodzą z danych, nigdy z zegara, więc nic tutaj nie zależy od strefy czasowej ani od rozjazdu zegara maszyny, na której działa zadanie.
                    Zakładka (Overlap)
                     |<------->|
   --o-----o------o--|----o----|-----o------o-----o-----o--|------------>  kolumna przyrostu
     |                        |                            |
     najstarszy wiersz        dolna krawędź pierwszego      sufit
     w źródle                 okna = znacznik celu          = najnowsza wartość w źródle
                              minus Overlap                   (rowversion: MIN_ACTIVE_ROWVERSION() - 1)

                              |<- ChunkSize ->|<- ChunkSize ->|
                              +---------------+---------------+-------+     dla każdego okna:
                              |    okno 1     |    okno 2     |  ...  |     TRUNCATE tabeli roboczej
                              +---------------+---------------+-------+     ładowanie okna
                                                                            MERGE do tabeli docelowej
                                                                            przerwa ChunkPauseSeconds
- Sufit — najnowsza wartość obecna w źródle w chwili startu. Wiersze, które pojawią się powyżej, poczekają na następne uruchomienie.
- Znacznik celu — najnowsza wartość już obecna w tabeli docelowej. To jedyna rzecz, którą zadanie pamięta, i leży ona w bazie docelowej, a nie w zadaniu.
- Zakładka (
Overlap) — o ile poniżej znacznika zaczyna się pierwsze okno. Jest potrzebna, bo transakcja rozpoczęta wcześniej może zatwierdzić się później: jej wiersze mają starszy znacznik niż wiersze już skopiowane.Overlapmusi być większy od najdłuższej transakcji zapisującej w źródle, inaczej takie wiersze zostaną pominięte na zawsze. Wiersze skopiowane po raz drugi na styku okien nie szkodzą —MERGEaktualizuje je w miejscu. ChunkSize— szerokość jednego okna. Ogranicza rozmiar dziennika transakcyjnego bazy docelowej przypadający na jedno okno, dzięki czemu pierwsze, pełne załadowanie dużej tabeli staje się praktycznie wykonalne.0oznacza jedno okno bez podziału.- Okna są domknięte jednostronnie,
(dolna, górna], dzięki czemu w obrębie jednej sesji żaden wiersz nie zostaje skopiowany dwukrotnie. - Pusty cel — pierwsze okno zaczyna się o jeden tik poniżej najstarszego wiersza źródła, dzięki czemu pierwsze ładowanie rozpoczyna się bezpośrednio od rzeczywistych danych, bez konieczności przechodzenia przez szereg pustych okien od najwcześniejszego możliwego momentu.
Jeśli przebieg zostanie przerwany albo zadanie zostanie zatrzymane, jego wykonywanie zatrzymuje się pomiędzy oknami. Znacznik celu pozostaje wówczas po prostu niższy, a kolejne uruchomienie rozpoczyna pracę od tej wartości.
Rodzaje kolumny przyrostu
Rodzaj wynika z wartości kolumny, nie z konfiguracji. Decyduje o tym, w jakich jednostkach podaje się
Overlap i ChunkSize:
| Typ kolumny | Jednostka okna | Uwagi |
|---|---|---|
datetime, datetime2, timestamp (Oracle/DB2/PostgreSQL), dowolna data z czasem | sekundy | Przypadek typowy. ChunkSize 86400 to jedna doba na okno. |
int, bigint, decimal, dowolny typ całkowity lub stałopozycyjny | jednostki klucza | Dla stale rosnącego klucza sztucznego albo sekwencji. ChunkSize 100000 to 100 000 kluczy na okno. |
rowversion / timestamp (SQL Server) | tiki licznika | Sufitem jest MIN_ACTIVE_ROWVERSION() - 1, poniżej którego nic nie może się już zatwierdzić, więc Overlap może być 0. Kolumna w celu musi być binary(8). |
Wymagania wobec kolumny, sprawdzane przez Check:
NOT NULL. Wiersz z wartościąNULLnigdy nie zostałby przypisany do żadnego okna, a poszczególne silniki bazodanowe różnią się sposobem sortowania wartościNULL, przez co same granice okien byłyby nieprzewidywalne.- Musi rosnąć przy każdej zmianie wiersza. Jeśli aplikacja aktualizuje wiersz bez modyfikacji tej kolumny, dana zmiana nie zostanie skopiowana. Jest to jedyny aspekt, którego zadanie nie jest w stanie zweryfikować automatycznie.
- Powinna być pierwszą kolumną w obrębie jakiegoś indeksu. Bez indeksu każde okno wymaga pełnego skanu tabeli, przez co podział na okna staje się niekorzystny zamiast pomocnego. Mechanizm Check zgłasza wówczas stosowne ostrzeżenie.
Zarówno tabela źródłowa, jak i docelowa muszą posiadać klucz główny po obu stronach — to na jego podstawie operacja MERGE dopasowuje odpowiadające sobie wiersze.
Parametry
Ustawiane w <params> zadania w hierarchii albo w oknie właściwości w archITekt Studio.
| Parametr | Etykieta w Studio | Domyślnie | Znaczenie |
|---|---|---|---|
SourceDbName | Baza źródłowa | – (wymagany) | Nazwa logiczna bazy źródłowej. |
DestinationDbName | Baza docelowa | globalny DefaultDbName | Nazwa logiczna bazy docelowej. |
FileName | – | nazwa zadania | Gdzie leży lista tabel: lista.txt;KATALOG_LOGICZNY (katalog logiczny z konfiguracji), samo lista.txt (szukane w globalnym DefaultDirName hierarchii, w katalogu logicznym TASKS albo obok pliku hierarchii) lub ścieżka absolutna. Bez tego parametru nazwą pliku jest nazwa zadania. |
Workers | Liczba wątków | 4 | Ile tabel kopiowanych równolegle. Przy pierwszym, pełnym ładowaniu zostaw 1, żeby nie zdławić źródła. |
Overlap | Zakładka okna | 300 | O ile cofnięte jest pierwsze okno, w jednostkach znacznika. Zob. Ruchome okno. |
ChunkSize | Szerokość okna | 86400 | Szerokość jednego okna, w jednostkach znacznika. 0 to jedno okno – rozsądne tylko dla małych tabel. |
ChunkPauseSeconds | Przerwa między oknami [s] | 1 | Przerwa w sekundach rzeczywistych między oknami, żeby źródło obsłużyło własny ruch. |
DeleteMode | Usunięcia | None | None albo KeySweep. Zob. Przenoszenie usunięć. |
CreateMissingTables | Zakładanie brakujących tabel | false | Zakłada w celu brakujące tabele i kolumny. Typy przepisuje wprost ze schematu źródła, więc ma to sens tylko między bazami tego samego silnika. |
BatchSize | Rozmiar wsadu | 1000 | Liczba wierszy w paczce BulkCopy. |
SqlBulkCopyOptions | Opcje BulkCopy | KeepIdentity | Zostaw KeepIdentity. Tabela robocza dziedziczy właściwość IDENTITY tabeli docelowej, więc bez tej flagi ładowanie przenumeruje klucze i MERGE trafi w niewłaściwe wiersze. |
StagingTableSchema | Schema tabeli roboczej | (pusta) | Schema tabeli roboczej, analogicznie do Schema tabel docelowych. Pusta oznacza tę samą schemę co tabela docelowa. |
StagingTablePrefix | Prefiks tabeli roboczej | (pusty) | Prefiks nazwy tabeli roboczej, analogicznie do Prefiks nazwy docelowej. |
StagingTableSuffix | Przyrostek tabeli roboczej | _INC | Przyrostek nazwy tabeli roboczej. Nie może być pusty – pusty wskazywałby tabelę docelową, a każde okno zaczyna się od wyczyszczenia tabeli roboczej. |
TargetSchema | Schema tabel docelowych | (pusta) | Schema tabel docelowych. Pusta oznacza tę samą schemę co w źródle. |
TargetPrefix | Prefiks nazwy docelowej | (pusty) | Doklejany przed nazwę tabeli docelowej. |
TargetSuffix | Sufiks nazwy docelowej | (pusty) | Doklejany za nazwę tabeli docelowej. |
SourceDbCmdTimeout, DestinationDbCmdTimeout | Timeout źródła / celu | 3600 | Timeout zapytań w sekundach. |
Nazwy tabel docelowych. Trzy konwencje nazwy nakładają nazwę źródłową na docelową. Dla tabeli źródłowej a.b: TargetSchema=x daje x.b; razem z TargetPrefix=p_ i TargetSuffix=_s daje x.p_b_s. Gdy wszystkie trzy są puste, tabela docelowa nazywa się dokładnie tak jak źródłowa, tyle że w drugiej bazie – przypadek typowy. Obie strony mogą być tą samą bazą, co jest wygodne do przetestowania całego mechanizmu, ale wtedy trzeba ustawić przynajmniej jedną z trzech konwencji, inaczej zadanie kopiowałoby tabele same w siebie; Check taką konfigurację odrzuca.
Lista tabel
Skryptem zadania jest zwykła lista tabel, jedna na linię. Kolumny rozdziela tabulator, bo nazwa tabeli może legalnie zawierać spacje.
dbo.Orders      ModifiedUtc
dbo.OrderLines  ModifiedUtc     WHERE Status = 'ACTIVE'     -Payload,-Notes
dbo.Events      EventId
# dbo.Heap      ChangedAt       brak klucza głównego, wyłączona do czasu jego dodania
| Kolumna | Wymagana | Znaczenie |
|---|---|---|
| 1 | tak | Nazwa tabeli, ze schemą jak w źródle. |
| 2 | tak | Kolumna przyrostu. |
| 3+ | nie | WHERE <warunek> i/lub -kolumna,-kolumna, w dowolnej kolejności. Wszystko inne to komentarz. |
- Linia zaczynająca się od
#albo--jest komentarzem. Tak wyłącza się tabelę bez usuwania jej z listy. WHERE <warunek>to gołe SQL doklejane do każdego zapytania o źródło – krawędzi okna, okien i przebiegu po kluczach – więc cel staje się spójnym lustrem podzbioru.-kolumna,-kolumnapowoduje wyłączenie wskazanych kolumn z procesu kopiowania. Pominięta kolumna nie musi istnieć w tabeli docelowej; jeśli jednak istnieje, operacjaMERGEjej nie modyfikuje, dzięki czemu tabela docelowa może przechowywać w niej własną wartość. Nie jest możliwe pominięcie kolumny klucza głównego ani kolumny przyrostu.- Samo
WHEREbez warunku jest błędem, a nie „brakiem filtra". - Lista wklejona ze spacjami zamiast tabulatorów spowoduje wyraźny błąd, zamiast w niezauważalny sposób zniekształcić nazwę.
Zamiast osobnego pliku lista może zostać umieszczona bezpośrednio w pliku XML hierarchii, jako wewnętrzny skrypt zadania.
Przykładowe zadanie w hierarchii:
<task>
    <name>MirrorOrders</name>
    <type>TaskModule.Task.CopyDataIncrements;TaskModule.dll</type>
    <status>START_PENDING</status>
    <params>
        <param key="FileName" value="MirrorOrders.txt;DATA_MIRROR_TASKS" />
        <param key="SourceDbName" value="SRC" />
        <param key="DestinationDbName" value="MIRROR" />
        <param key="ChunkSize" value="3600" />
    </params>
    <nextTasks/>
</task>
W archITekt Studio
Zadanie znajduje się w przyborniku pod nazwą Kopiowanie przyrostowe. Po przeciągnięciu go na graf hierarchii powstaje zadanie z wypełnionym typem, plikiem skryptu utworzonym na podstawie wzorca – zawierającym zakomentowany przykład listy tabel – oraz parametrami widocznymi w oknie właściwości pod etykietami z tabeli powyżej. Dwukrotne kliknięcie zadania otwiera listę tabel w edytorze tekstu.
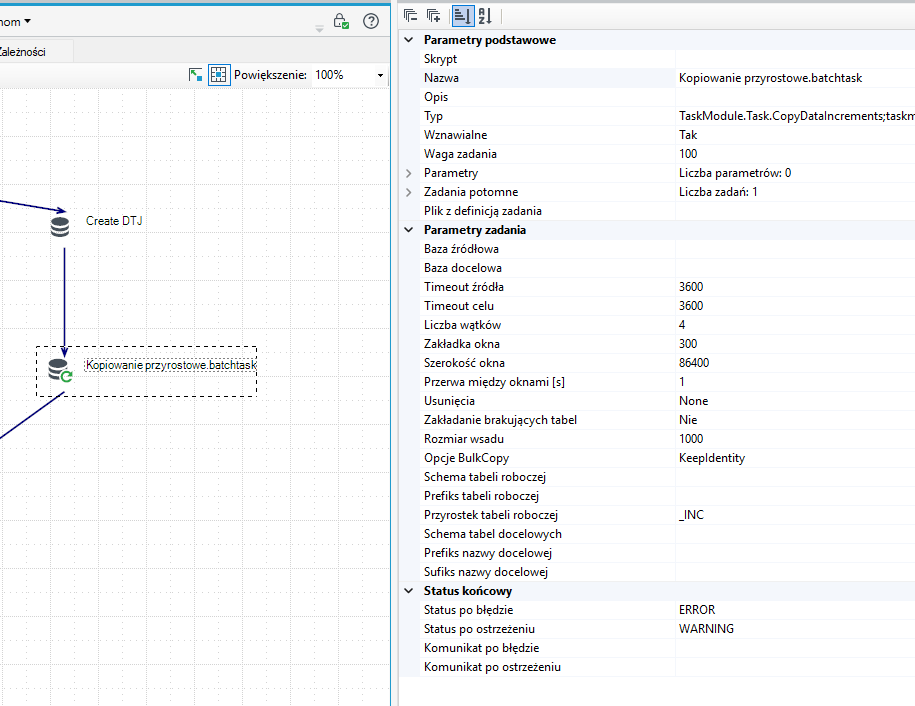
Check zachowuje się odmiennie w trybie projektowym: w archITekt Studio weryfikuje listę tabel oraz konfigurację zadania, lecz nie nawiązuje połączenia z bazami danych, dzięki czemu walidacja hierarchii pozostaje szybka i możliwa do przeprowadzenia ze stacji roboczej niemającej dostępu do baz danych. Kontrole schematu wymienione poniżej są wykonywane na serwerze, przed uruchomieniem zadania.
Jedna tabela, krok po kroku
- Zadanie pyta bazę źródłową o najnowszą wartość przyrostu (pierwszy wiersz po indeksie) → baza źródłowa zwraca sufit.
- Zadanie pyta bazę docelową o najnowszą wartość przyrostu w tabeli docelowej → baza docelowa zwraca znacznik celu.
- Dolna krawędź pierwszego okna = znacznik minus Overlap (dla pustego celu: tik poniżej najstarszego wiersza źródła).
- Zadanie zakłada w bazie docelowej tabelę roboczą, jeśli jeszcze nie istnieje.
- Dla każdego okna o szerokości ChunkSize:
TRUNCATEtabeli roboczej → odczyt okna ze źródła (dolna krawędź wyłącznie, górna włącznie) → ładowanieBulkCopydo tabeli roboczej →MERGEtabeli roboczej w docelową po kluczu głównym → przerwa ChunkPauseSeconds. - Jeżeli DeleteMode =
KeySweep:TRUNCATEtabeli kluczy → odczyt wszystkich wartości klucza głównego ze źródła → ładowanieBulkCopydo tabeli kluczy →DELETEwierszy celu bez pary w tabeli kluczy.
Przenoszenie usunięć
Znacznik czasu nie jest w stanie wyrazić faktu usunięcia: wiersz po prostu przestaje istnieć, a żadne okno nigdy o nim nie wspomni. Przy ustawieniu DeleteMode = None (wartość domyślna) usunięte wiersze pozostają zatem w tabeli docelowej bezterminowo.
Ustawienie DeleteMode = KeySweep eliminuje ten problem. Po skopiowaniu wszystkich okien danej tabeli zadanie wczytuje komplet kluczy głównych ze źródła do drugiej tabeli roboczej, a następnie usuwa z tabeli docelowej każdy wiersz, dla którego nie znaleziono odpowiednika. Operacja ta jest celowo wykonywana po przetworzeniu okien: wiersz wstawiony pomiędzy pobraniem kluczy a kopiowaniem danych zostałby skopiowany, a następnie natychmiast usunięty jako rekord osierocony.
W praktyce:
- Jest to pełny przebieg po kluczach źródła, w związku z czym koszt odpowiada w przybliżeniu jednemu pełnemu odczytowi kolumn klucza. Jest to znacznie tańsze niż kopiowanie całej tabeli, jednak nie pozbawione kosztu.
- Zaleca się przypisanie mu osobnego węzła hierarchii z ustawieniem
DeleteMode = KeySweep, uruchamianego rzadziej niż przyrosty – na przykład raz na dobę lub raz w tygodniu, w zależności od tego, jak długo można tolerować obecność zaległego, usuniętego wiersza. - Jeżeli tabela źródłowa okaże się pusta, przebieg zostaje pominięty wraz z odpowiednim ostrzeżeniem, zamiast prowadzić do wyczyszczenia tabeli docelowej – puste źródło znacznie częściej wynika z błędu konfiguracji niż z zamierzonego działania.
- Usunięcia stanowią jedyny przypadek, w którym zapis do tabeli docelowej odbywa się poza operacją
MERGE, dlatego wykorzystywane konto musi posiadać uprawnienieDELETEdo tabel docelowych.
Check – tryb raportu
Check wykonuje się przed każdym startem, a w archITekt Studio można go wywołać na żądanie. Jest czystym raportem: łączy się z obiema bazami, czyta oba schematy i nic nie zapisuje. W archITekt Studio zatrzymuje się na liście tabel i konfiguracji, i nie łączy się z bazami – zob. W archITekt Studio.
Sprawdza, dla każdej tabeli:
- czy tabela istnieje w źródle oraz czy odpowiadająca jej tabela istnieje w bazie docelowej (lub zostanie utworzona, jeśli włączona jest opcja
CreateMissingTables); - czy kolumna przyrostu istnieje i posiada atrybut
NOT NULL; - czy obie tabele posiadają klucz główny oraz czy kolumny klucza tabeli docelowej istnieją również w tabeli źródłowej;
- czy każda kopiowana kolumna istnieje w tabeli docelowej;
- czy kolumny pominięte w kopiowaniu istnieją w tabeli źródłowej, nie stanowią klucza głównego ani kolumny przyrostu oraz nie posiadają w tabeli docelowej atrybutu
NOT NULLbez zdefiniowanej wartości domyślnej; - czy tabela docelowa nie zawiera kolumny typu
rowversioninnej niżbinary(8); - czy istniejąca tabela robocza posiada ten sam zestaw kolumn co tabela kopiowana;
- czy tabela źródłowa i tabela docelowa nie są tą samą tabelą.
Ostrzega, gdy kolumna przyrostu nie jest pierwszą kolumną żadnego indeksu – kopiowanie będzie działać i będzie wolne.
Zakładane obiekty i uprawnienia
| Obiekt | Gdzie | Kto zakłada | Uwagi |
|---|---|---|---|
Tabela robocza cel + StagingTableSuffix | baza docelowa | zadanie, przy pierwszym użyciu | SELECT ... INTO z tabeli docelowej plus indeks po kluczu głównym. Zostaje między uruchomieniami i jest ponownie używana. |
Tabela kluczy robocza + _KEYS | baza docelowa | zadanie, przy pierwszym użyciu, tylko przy KeySweep | Wyłącznie kolumny klucza głównego. |
| Tabele docelowe i brakujące kolumny | baza docelowa | tylko przy CreateMissingTables | Tabele bez IDENTITY, dokładane kolumny zawsze NULL. |
Minimalne uprawnienia:
- Źródło:
SELECTna wymienionych tabelach. Nic więcej, nigdy. - Cel:
SELECT,INSERT,UPDATEna tabelach docelowych, a przyKeySweeptakżeDELETE; na tabelach roboczych dodatkowo prawo doTRUNCATE(na SQL Serverze toALTERna tabeli).CREATE TABLEiCREATE INDEX, o ile nie założysz tabel roboczych ręcznie. Cel z kolumną IDENTITY wymaga dodatkowo prawa do przełączaniaIDENTITY_INSERT.
Wsparcie silników
Mechanizm jest obojętny silnikowo poza dwoma miejscami:
- Tworzenie tabel roboczych odbywa się za pomocą składni
SELECT ... INTO, właściwej dla SQL Servera. W przypadku innego silnika bazodanowego po stronie docelowej należy jednorazowo utworzyć tabele robocze ręcznie – jako kopie tabeli docelowej (lub wyłącznie jej kolumn klucza) wraz z indeksem opartym na kluczu głównym. Pozostała część mechanizmu działa wówczas bez żadnych zmian. - Proces ładowania wykorzystuje szybki protokół BulkCopy, jeżeli bazą docelową jest SQL Server, natomiast w pozostałych przypadkach korzysta z instrukcji
INSERTwykonywanych w paczkach. Oba warianty działają poprawnie, jednak wariant zastępczy charakteryzuje się niższą wydajnością.
Scalanie korzysta z MERGE silnika tam, gdzie on istnieje, a gdzie nie – z pary UPDATE + INSERT wygenerowanej z tej samej definicji. Przebieg kasujący to przenośne NOT EXISTS. Źródłem może być dowolny silnik wspierany przez platformę.
Przepisy
- Pierwsze, pełne ładowanie.
Workers = 1,ChunkSizena tyle mały, żeby jedno okno liczyło się w minutach, nie w godzinach (dla ruchliwej tabeli – godzina danych),ChunkPauseSecondskilka sekund. Najpierw Check, potem niech idzie; przejdzie od najstarszego wiersza do najnowszego przez tyle okien, ile trzeba.WorkersiChunkSizepodnieś, kiedy nadrobi. - Stan ustalony.
ChunkSizerówny dobie jest odpowiedni, gdy odstęp między uruchomieniami jest znacznie krótszy niż doba: w takiej sytuacji zazwyczaj przypada jedno okno na przebieg. WartośćOverlappowinna przekraczać o kilka minut czas trwania najdłuższej transakcji zapisującej. - Lustro podzbioru. Należy dodać warunek
WHEREw linii opisującej tabelę. Warto pamiętać, że późniejsze zawężenie filtra pozostawia w tabeli docelowej wiersze, które nie należą już do danego podzbioru – zostaną one usunięte podczas przebieguKeySweep. Rozszerzenie filtra jest trudniejsze do przeprowadzenia: nowo objęte, starsze wiersze znajdują się poniżej znacznika celu i nie zostaną automatycznie uwzględnione, w związku z czym konieczne jest usunięcie tabeli docelowej (lub dotkniętych wierszy) i ponowne wczytanie danych przez zadanie. - Szeroka tabela, węższa kopia. Zaleca się wyłączenie niepotrzebnych kolumn za pomocą oznaczenia
-kolumna. Rozwiązanie to ogranicza ruch sieciowy, nie zmniejsza natomiast obciążenia po stronie źródła. - Testowanie mechanizmu w obrębie jednej bazy danych. Należy wskazać tę samą bazę danych jako źródłową i docelową oraz ustawić parametr
TargetSuffix = _COPY. W przypadku pominięcia tego ustawienia konfiguracja zostanie odrzucona przez mechanizm Check, co uniemożliwia przypadkowe skopiowanie tabel do samych siebie.
Ograniczenia i pułapki
- Aktualizacja niemodyfikująca kolumny przyrostu pozostaje niewidoczna dla mechanizmu. Żadna z opisanych funkcjonalności nie jest w stanie takiej zmiany wykryć.
- Wartość
Overlapmniejsza niż czas trwania najdłuższej transakcji powoduje ciche pominięcie części wierszy. Jest to jedyny parametr, którego wartość warto ustalić na podstawie pomiaru, a nie oszacowania. - Obsługa usunięć wymaga ustawienia
DeleteMode = KeySweep. Bez tego ustawienia rozmiar tabeli docelowej wyłącznie rośnie. - Brak spójności pomiędzy tabelami. Poszczególne tabele są przetwarzane niezależnie i równolegle, w związku z czym raport odwołujący się jednocześnie do dwóch odzwierciedlonych tabel może zaobserwować jedną z nich w stanie nieznacznie starszym niż druga.
- Zmiana filtra lub listy kolumn wymaga zachowania ostrożności. Zob. Przepisy powyżej; nieaktualna tabela robocza zawierająca poprzedni zestaw kolumn jest zgłaszana przez mechanizm Check – należy ją usunąć, zostanie ona utworzona ponownie.
- Zmiana schematu w tabeli źródłowej (np. dodanie nowej kolumny) jest zgłaszana przez mechanizm Check do momentu, w którym odpowiadająca jej kolumna zostanie dodana w tabeli docelowej – ręcznie albo za pomocą opcji
CreateMissingTables.
Błędy, zatrzymanie i wznawianie
- Niepowodzenie przetwarzania jednej tabeli nie zatrzymuje przetwarzania pozostałych; przebieg kończy się statusem
ERROR, a tabele, dla których wystąpił błąd, zostają wymienione w komunikacie zadania. - Błąd zaklasyfikowany jako błąd serwera (np. zerwane połączenie, restart usługi, zakleszczenie) skutkuje, zamiast statusem
ERROR, ustawieniem po upływie minuty statusuRESUME_PENDING, po czym harmonogram ponownie uruchamia zadanie. Wznowienie stanowi zwykłe ponowne uruchomienie i jest bezpieczne właśnie dlatego, że znacznik celu jest jedynym elementem pamiętanym przez zadanie. - Zatrzymanie zadania umożliwia dokończenie przetwarzania bieżącego okna, po czym zadanie zatrzymuje się przed rozpoczęciem kolejnego. Przebieg oparty na kluczach zostaje w takim przypadku pominięty. Żadne okno nie zostaje scalone częściowo: dane okno zostaje scalone w całości albo wcale.
Komunikaty w logu, które warto znać
| Komunikat | Co znaczy |
|---|---|
{0}: {1} wiersz(y), znacznik przesunięty do {2} | Informacja o postępie przetwarzania tabeli w trakcie nadrabiania zaległości – jeden wiersz komunikatu na każde okno. |
{0}: {1} wiersz(y) w czasie {2}. | Tabela osiągnęła stan bieżący (nadrobiła zaległości). |
{0}: tabela źródłowa jest pusta - nie ma czego kopiować. | Tabela źródłowa nie zawiera żadnych wierszy lub żaden z nich nie spełnia warunku filtra. |
{0}: bez indeksu na {1} każde okno to pełny skan - dzielenie na okna wtedy szkodzi, a nie pomaga. | Ostrzeżenie zgłaszane przez mechanizm Check. Należy dodać indeks lub ustawić wartość ChunkSize = 0. |
{0}: przenoszenie usunięć pominięte - puste źródło wyczyściłoby cały cel... | Mechanizm KeySweep odmówił wykonania operacji na pustym źródle. Należy zweryfikować filtr oraz zawartość tabeli źródłowej. |
{0}: tabela robocza {1} ma inny zestaw kolumn niż kopiowany - skasuj ją, zostanie założona od nowa. | Zmianie uległa lista kolumn lub schemat tabeli docelowej. Należy usunąć tabelę roboczą. |
{0}: kolumna przyrostu {1} dopuszcza NULL - musi być NOT NULL. | Należy poprawić definicję kolumny w tabeli źródłowej lub wybrać inną kolumnę przyrostu. |
Nieobsługiwany typ kolumny przyrostu: {0} - dozwolone są znaczniki czasu, liczby całkowite, decimal i rowversion. | Kolumna posiada typ danych, dla którego nie można wyznaczyć okien, lub jej typ różni się pomiędzy tabelą źródłową a docelową. |
Strony kodowe
Poniższa tabela prezentuje numery kodowań (wartość występujących w różnych miejscach parametrów „Encoding”) wraz z opisem i numerem strony kodowej Windows.
| CodePage | Identifier and name | WindowsCodePage |
|---|---|---|
| 37 | IBM037 | 1252 * |
| 437 | IBM437 | 1252 * |
| 500 | IBM500 | 1252 * |
| 708 | ASMO-708 | 1256 * |
| 720 | DOS-720 | 1256 * |
| 737 | ibm737 | 1253 * |
| 775 | ibm775 | 1257 * |
| 850 | ibm850 | 1252 * |
| 852 | ibm852 | 1250 * |
| 855 | IBM855 | 1252 * |
| 857 | ibm857 | 1254 * |
| 858 | IBM00858 | 1252 * |
| 860 | IBM860 | 1252 * |
| 861 | ibm861 | 1252 * |
| 862 | DOS-862 | 1255 * |
| 863 | IBM863 | 1252 * |
| 864 | IBM864 | 1256 * |
| 865 | IBM865 | 1252 * |
| 866 | cp866 | 1251 * |
| 869 | ibm869 | 1253 * |
| 870 | IBM870 | 1250 * |
| 874 | windows-874 | 874 |
| 875 | cp875 | 1253 * |
| 932 | shift_jis | 932 |
| 936 | gb2312 | 936 |
| 949 | ks_c_5601-1987 | 949 |
| 950 | big5 | 950 |
| 1026 | IBM1026 | 1254 * |
| 1047 | IBM01047 | 1252 * |
| 1140 | IBM01140 | 1252 * |
| 1141 | IBM01141 | 1252 * |
| 1142 | IBM01142 | 1252 * |
| 1143 | IBM01143 | 1252 * |
| 1144 | IBM01144 | 1252 * |
| 1145 | IBM01145 | 1252 * |
| 1146 | IBM01146 | 1252 * |
| 1147 | IBM01147 | 1252 * |
| 1148 | IBM01148 | 1252 * |
| 1149 | IBM01149 | 1252 * |
| 1200 | utf-16 | 1200 |
| 1201 | unicodeFFFE | 1200 * |
| 1250 | windows-1250 | 1250 |
| 1251 | windows-1251 | 1251 |
| 1252 | Windows-1252 | 1252 |
| 1253 | windows-1253 | 1253 |
| 1254 | windows-1254 | 1254 |
| 1255 | windows-1255 | 1255 |
| 1256 | windows-1256 | 1256 |
| 1257 | windows-1257 | 1257 |
| 1258 | windows-1258 | 1258 |
| 1361 | Johab | 949 * |
| 10000 | macintosh | 1252 * |
| 10001 | x-mac-japanese | 932 * |
| 10002 | x-mac-chinesetrad | 950 * |
| 10003 | x-mac-korean | 949 * |
| 10004 | x-mac-arabic | 1256 * |
| 10005 | x-mac-hebrew | 1255 * |
| 10006 | x-mac-greek | 1253 * |
| 10007 | x-mac-cyrillic | 1251 * |
| 10008 | x-mac-chinesesimp | 936 * |
| 10010 | x-mac-romanian | 1250 * |
| 10017 | x-mac-ukrainian | 1251 * |
| 10021 | x-mac-thai | 874 * |
| 10029 | x-mac-ce | 1250 * |
| 10079 | x-mac-icelandic | 1252 * |
| 10081 | x-mac-turkish | 1254 * |
| 10082 | x-mac-croatian | 1250 * |
| 12000 | utf-32 | 1200 * |
| 12001 | utf-32BE | 1200 * |
| 20000 | x-Chinese-CNS | 950 * |
| 20001 | x-cp20001 | 950 * |
| 20002 | x-Chinese-Eten | 950 * |
| 20003 | x-cp20003 | 950 * |
| 20004 | x-cp20004 | 950 * |
| 20005 | x-cp20005 | 950 * |
| 20105 | x-IA5 | 1252 * |
| 20106 | x-IA5-German | 1252 * |
| 20107 | x-IA5-Swedish | 1252 * |
| 20108 | x-IA5-Norwegian | 1252 * |
| 20127 | us-ascii | 1252 * |
| 20261 | x-cp20261 | 1252 * |
| 20269 | x-cp20269 | 1252 * |
| 20273 | IBM273 | 1252 * |
| 20277 | IBM277 | 1252 * |
| 20278 | IBM278 | 1252 * |
| 20280 | IBM280 | 1252 * |
| 20284 | IBM284 | 1252 * |
| 20285 | IBM285 | 1252 * |
| 20290 | IBM290 | 932 * |
| 20297 | IBM297 | 1252 * |
| 20420 | IBM420 | 1256 * |
| 20423 | IBM423 | 1253 * |
| 20424 | IBM424 | 1255 * |
| 20833 | x-EBCDIC-KoreanExtended | 949 * |
| 20838 | IBM-Thai | 874 * |
| 20866 | koi8-r | 1251 * |
| 20871 | IBM871 | 1252 * |
| 20880 | IBM880 | 1251 * |
| 20905 | IBM905 | 1254 * |
| 20924 | IBM00924 | 1252 * |
| 20932 | EUC-JP | 932 * |
| 20936 | x-cp20936 | 936 * |
| 20949 | x-cp20949 | 949 * |
| 21025 | cp1025 | 1251 * |
| 21866 | koi8-u | 1251 * |
| 28591 | iso-8859-1 | 1252 * |
| 28592 | iso-8859-2 | 1250 * |
| 28593 | iso-8859-3 | 1254 * |
| 28594 | iso-8859-4 | 1257 * |
| 28595 | iso-8859-5 | 1251 * |
| 28596 | iso-8859-6 | 1256 * |
| 28597 | iso-8859-7 | 1253 * |
| 28598 | iso-8859-8 | 1255 * |
| 28599 | iso-8859-9 | 1254 * |
| 28603 | iso-8859-13 | 1257 * |
| 28605 | iso-8859-15 | 1252 * |
| 29001 | x-Europa | 1252 * |
| 38598 | iso-8859-8-i | 1255 * |
| 50220 | iso-2022-jp | 932 * |
| 50221 | csISO2022JP | 932 * |
| 50222 | iso-2022-jp | 932 * |
| 50225 | iso-2022-kr | 949 * |
| 50227 | x-cp50227 | 936 * |
| 51932 | euc-jp | 932 * |
| 51936 | EUC-CN | 936 * |
| 51949 | euc-kr | 949 * |
| 52936 | hz-gb-2312 | 936 * |
| 54936 | GB18030 | 936 * |
| 57002 | x-iscii-de | 57002 |
| 57003 | x-iscii-be | 57003 |
| 57004 | x-iscii-ta | 57004 |
| 57005 | x-iscii-te | 57005 |
| 57006 | x-iscii-as | 57006 |
| 57007 | x-iscii-or | 57007 |
| 57008 | x-iscii-ka | 57008 |
| 57009 | x-iscii-ma | 57009 |
| 57010 | x-iscii-gu | 57010 |
| 57011 | x-iscii-pa | 57011 |
| 65000 | utf-7 | 1200 * |
| 65001 | utf-8 | 1200 * |
Inne zadania
Puste zadanie
Zadanie nie wykonujące żadnych użytecznych operacji, służy jako centralny punkt startowy, końcowy lub synchronizacyjny w sieci zależności.
Zadanie c#
Inne zadanie zdefiniowane w kodzie Systemu, nie posiadające własnej dedykowanej ikonki. Może realizować całkowicie dowolne funkcje. Definicja wymaga znajomości programowania w .NET i obsługi kompilatora.